把收藏的文章织成一张网:用 Codex + Obsidian 实践 Karpathy 的 LLM Wiki
把收藏的文章织成一张网:用 Codex + Obsidian 实践 Karpathy 的 LLM Wiki
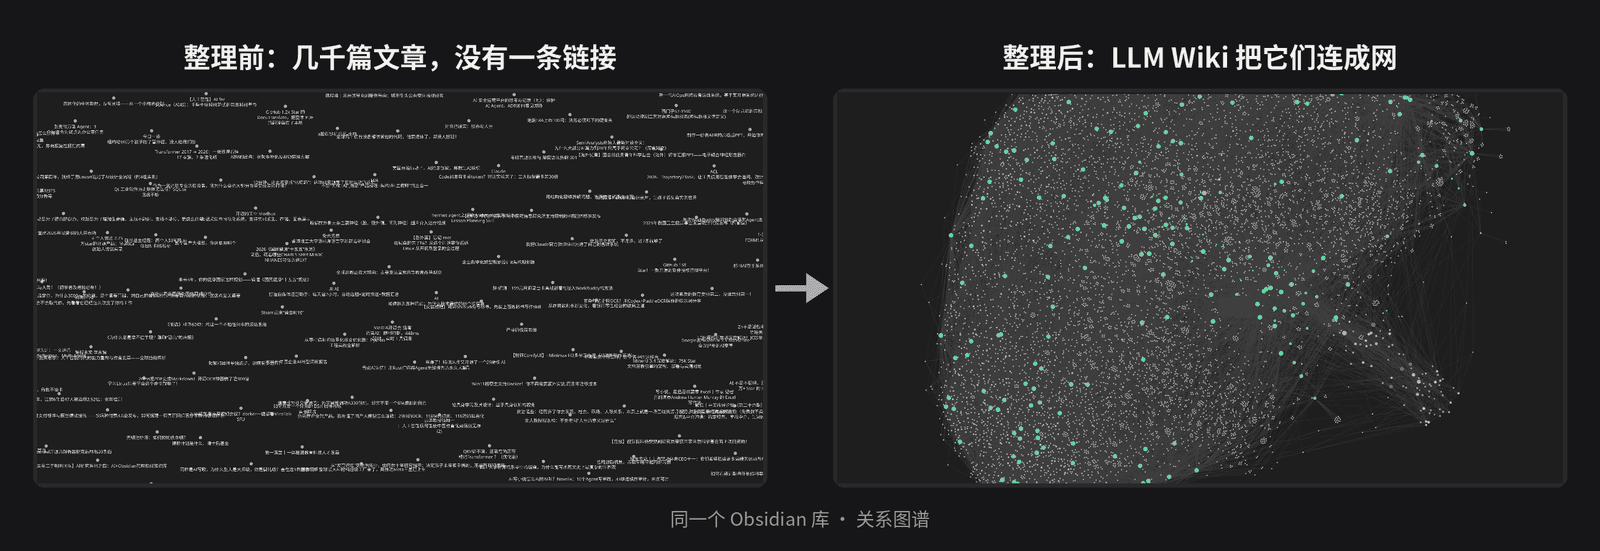
左边是整理前:一万篇文章,一万个孤零零的点。右边是整理后:同一个库,被 Codex 按 Karpathy 的「LLM Wiki」模式织成了一张网——橙色是主题页,蓝色是子主题页,绿色是实体页,紫色是概念页,黄色是来源精读页,灰色的小点还是那一万篇原文,只是每一篇都被挂进了网里。两张图都是真实的 Obsidian 关系图谱截图,中间只隔了一次 47 分钟的 Codex 会话。
这篇文章把整个过程完整走一遍:素材从哪来、LLM Wiki 的逻辑是什么、怎么让 Codex 动手整理、整理完能拿来干什么,以及最后一步——怎么配置「笔记同步助手」插件,让以后新保存的文章自动落到正确的位置,不用再手动搬。
0. 素材:几千篇真实文章
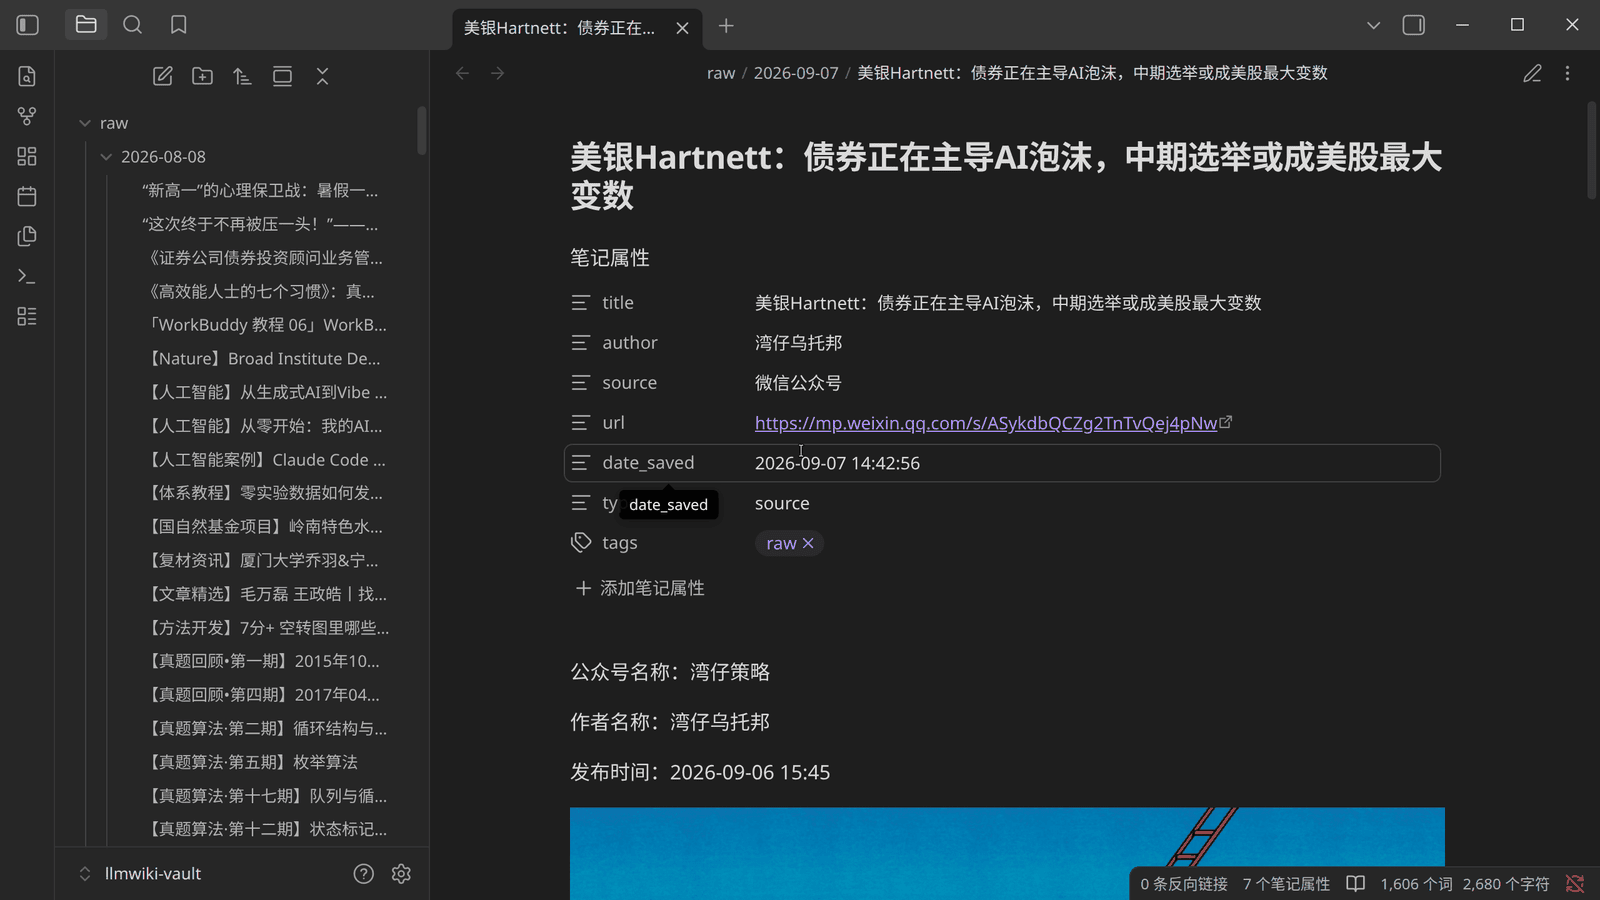
素材是我这几年用「笔记同步助手」一篇一篇攒下来的几千篇文章,AI、编程、投资、心理、教育、健康都有。
它们按插件的默认习惯堆在 raw/<保存日期>/<标题>.md 里,每篇带一段笔记属性(标题、作者、来源、原文链接、保存时间)。
1. 先看「整理前」:怎么打开关系图谱
Obsidian 的关系图谱是看这个库「长什么样」最直观的方式。进入方式有两个:
方式一:点左侧边栏那个三个小圆点连在一起的图标,悬停会提示「查看关系图谱」。
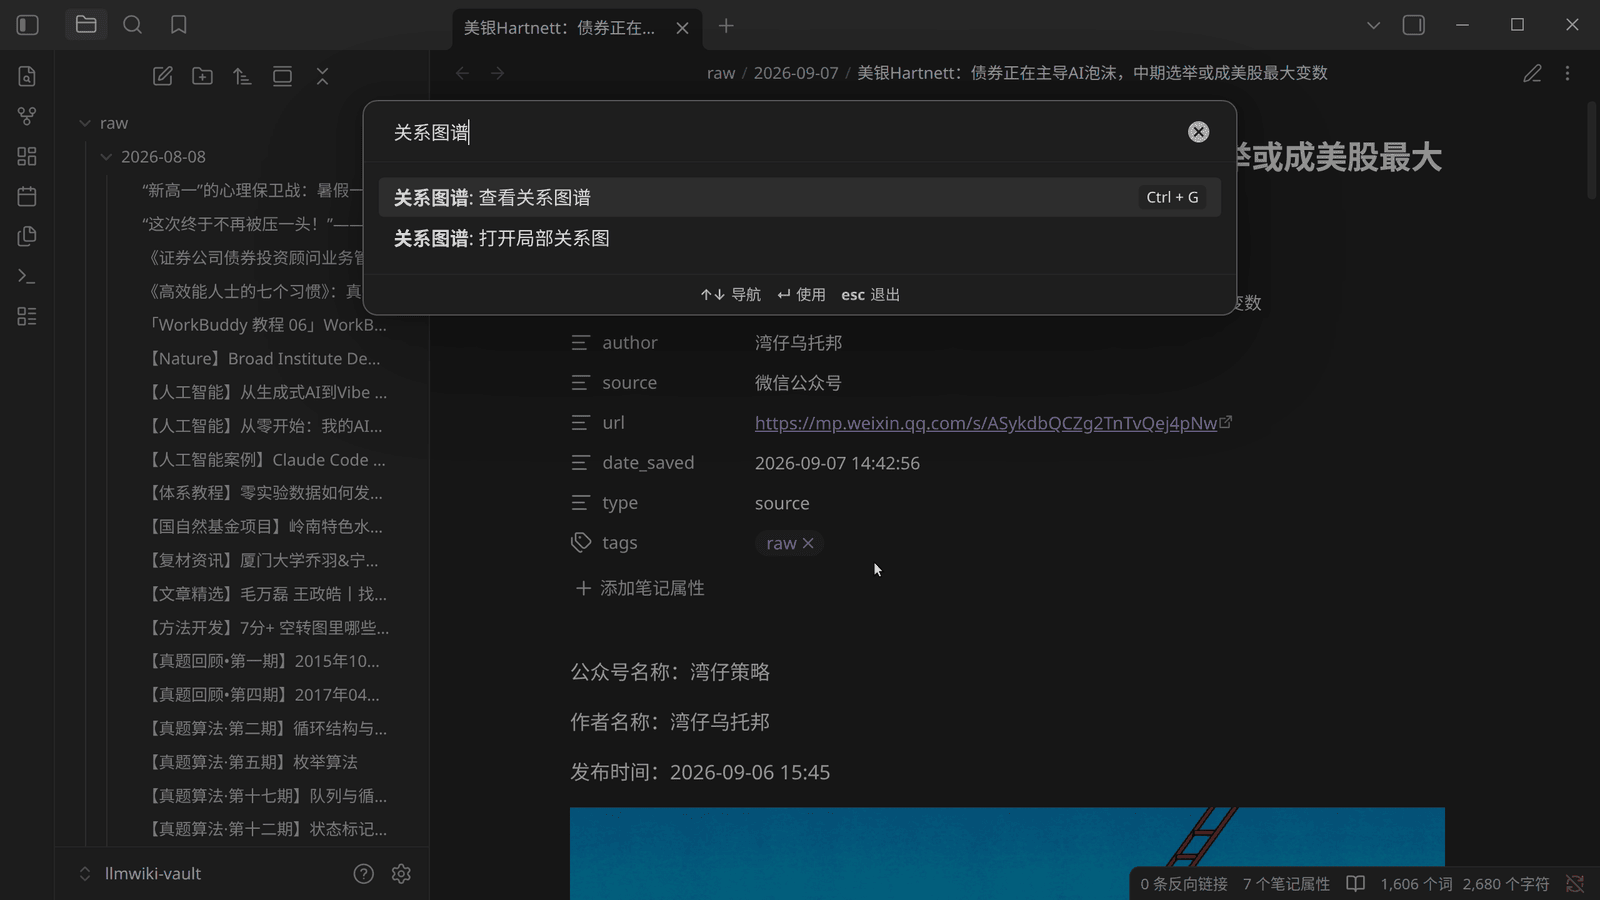
方式二:Ctrl + P 打开命令面板,输入「关系图谱」,回车。默认快捷键是 Ctrl + G。旁边那条「打开局部关系图」是只看当前笔记周围一圈的小图,后面会用到。
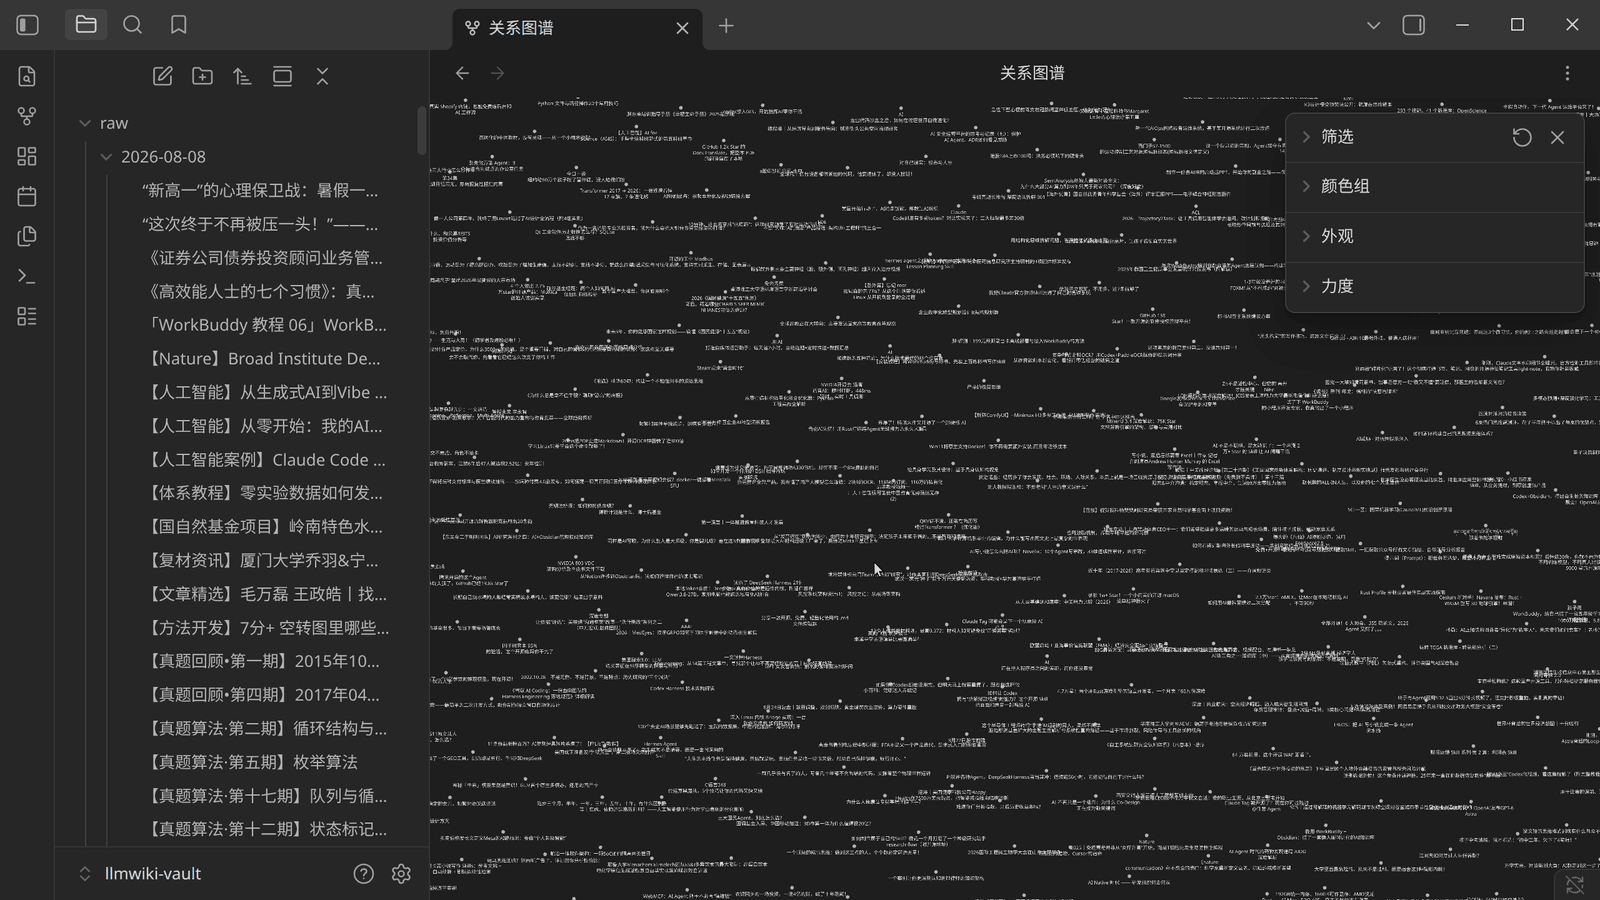
打开之后,右上角的齿轮是图谱设置面板(筛选 / 颜色组 / 外观 / 力度)。刚打开时是放大状态,能看见一颗颗带标题的点:
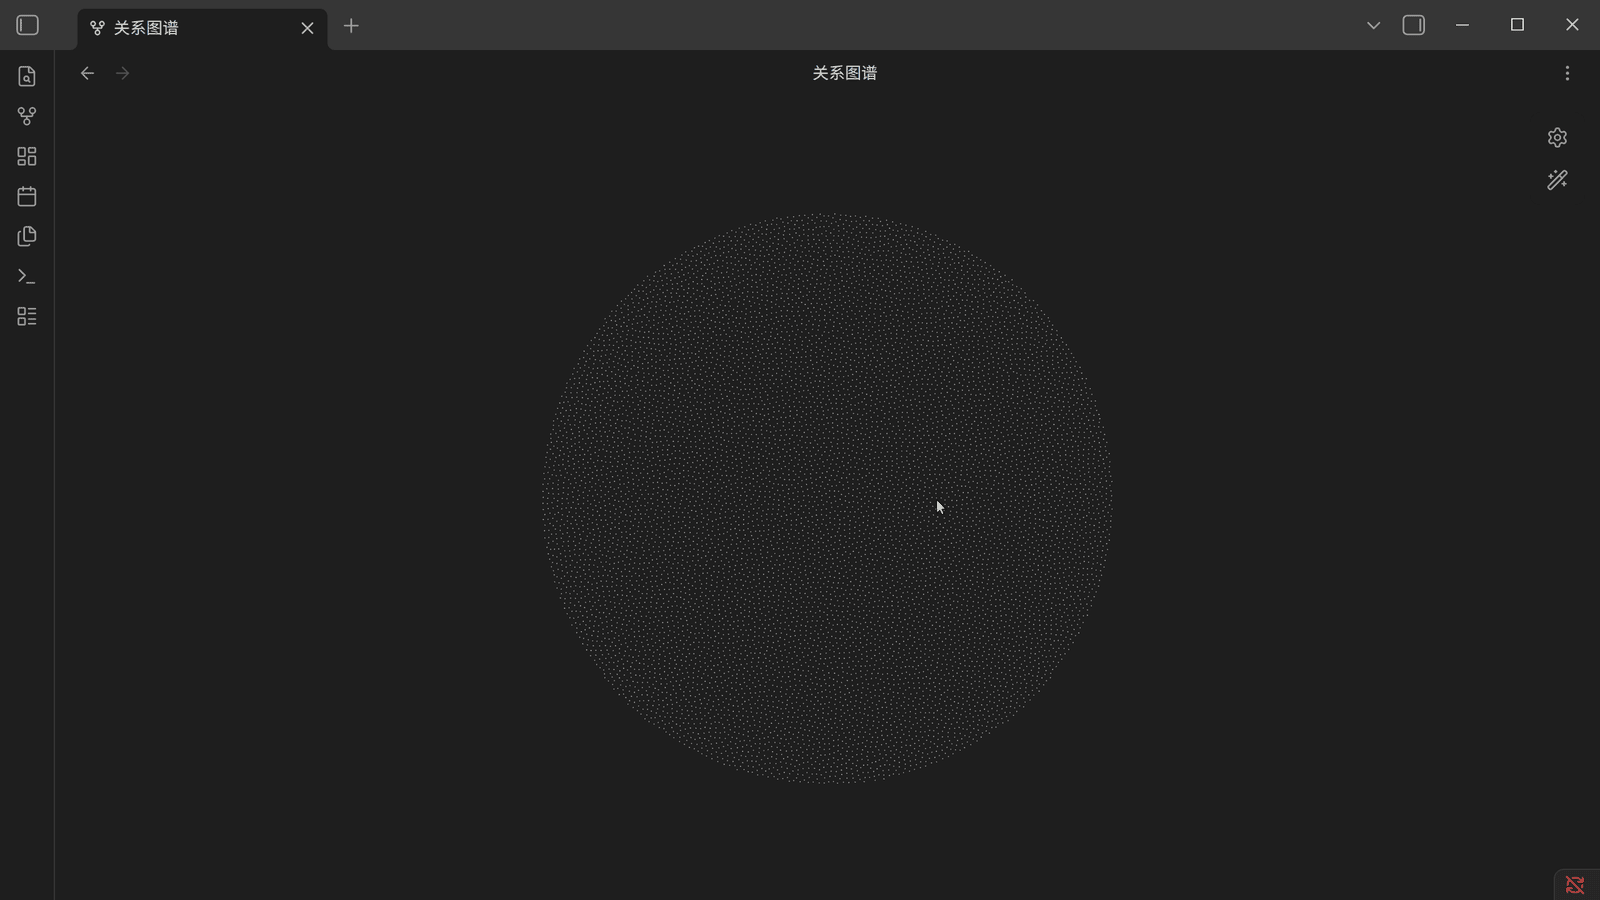
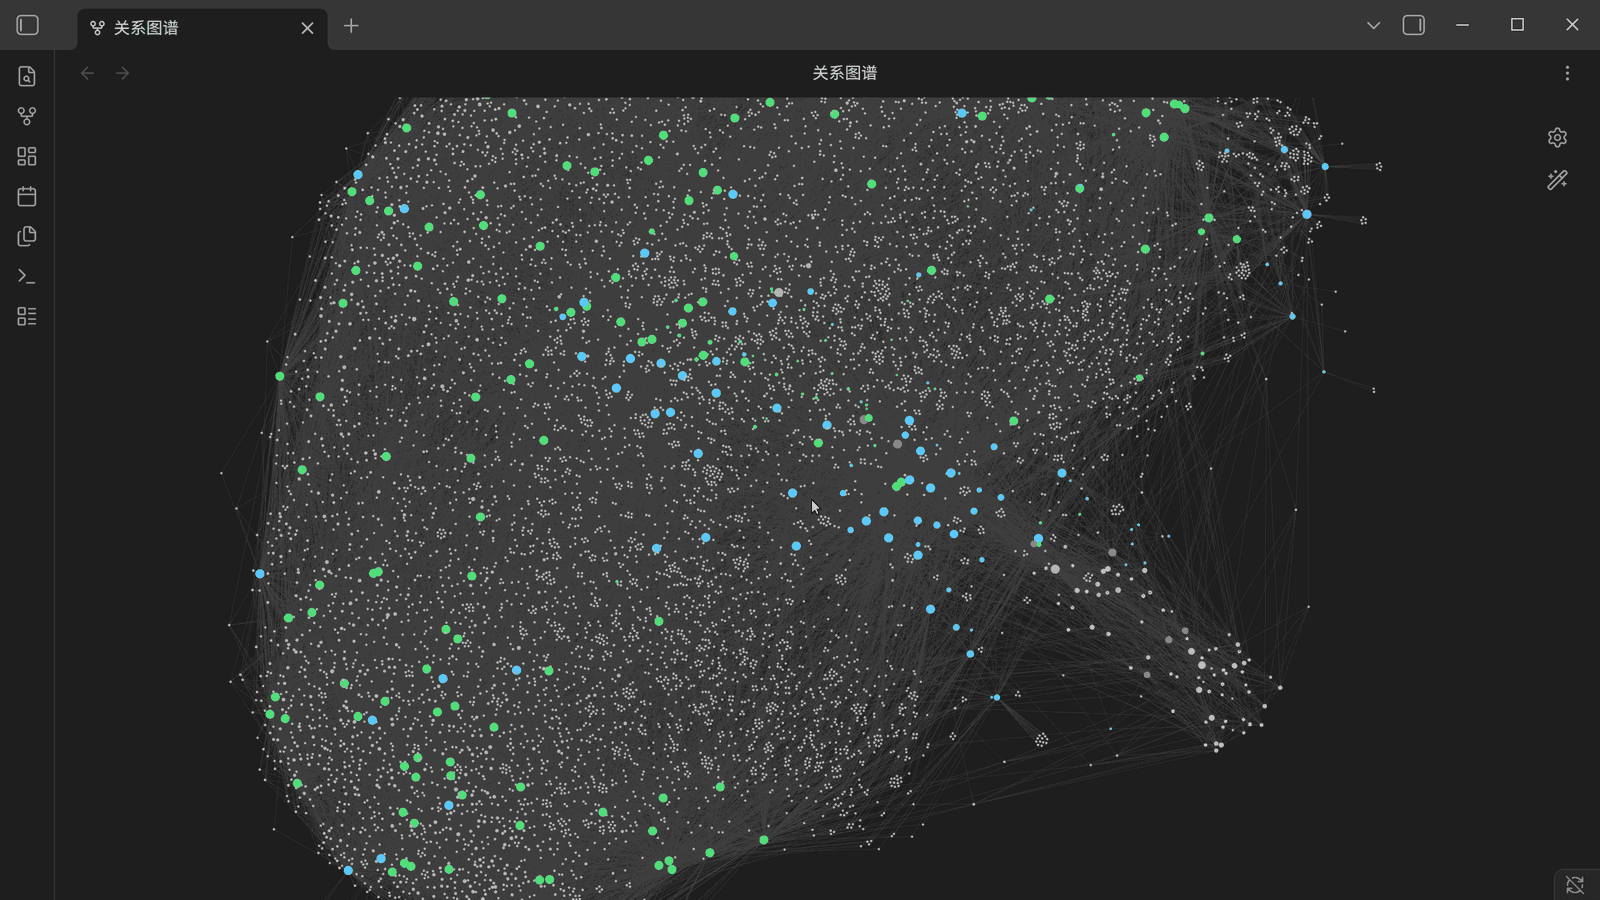
鼠标滚轮缩小,一万篇文章就是这样一个均匀的圆盘。没有一条线——因为这些文章之间本来就不存在链接,保存了多少篇,就是多少个孤点。这就是绝大多数人「收藏了很多、但从来没用起来」的知识库的真实形状。
2. LLM Wiki 的逻辑:让模型当图书管理员,而不是每次现查
2026 年 4 月,Andrej Karpathy 发了一份叫 LLM Wiki 的 idea file。它不是代码,是一段给 AI agent 看的说明书,设计目的就是「复制粘贴给你自己的 Codex / Claude Code」。核心想法可以压缩成三句话:
第一,RAG 是「每次现查」,LLM Wiki 是「一次编译、持续维护」。 常见的「上传一堆文件然后提问」的用法,模型每次都从原始文档里重新找片段、重新拼答案,问十次就重复十次,什么都没有沉淀下来。LLM Wiki 反过来:每加进一篇新来源,模型就读一遍、把要点写进 wiki、更新相关的实体页和概念页、标出和已有说法矛盾的地方。知识被整理一次,之后一直保持最新。
第二,三层结构。
raw/:原始来源。不可变,模型只读不写,是唯一的事实来源。wiki/:模型生成并维护的 Markdown 页面——摘要、实体页、概念页、总览、综述。你读,模型写。- schema(
AGENTS.md或CLAUDE.md):告诉模型这个 wiki 的目录结构、页面模板、命名规则,以及三种操作各自怎么做。这份文件是让模型变成「守纪律的 wiki 维护者」而不是「泛泛而谈的聊天机器人」的关键。
第三,三种操作。
- Ingest:丢一篇新来源进
raw/,让模型处理——读、写摘要页、更新索引、更新涉及的实体/概念页、往日志追加一条。一篇来源可能碰到十几个页面。 - Query:对着 wiki 提问。模型先读索引找相关页,再读页面,带引用地回答。好的回答要 file 回 wiki 变成新页面,这样你的提问也在为知识库做贡献。
- Lint:定期让模型体检——页面之间的矛盾、被新来源推翻的旧结论、没人链接的孤儿页、提到了但没有专页的概念。
另外两个特殊文件:index.md 是内容目录(每页一行链接 + 一句话摘要,按类别组织,模型每次 ingest 都更新),log.md 是只追加的时间线(每条以 ## [日期] ingest|query|lint | 标题 开头,grep "^## \[" log.md | tail -5 就能看最近五条)。
Karpathy 自己的用法是:「LLM agent 开在一边,Obsidian 开在另一边。模型根据对话改文件,我在 Obsidian 里实时看结果——点链接、看图谱、读更新过的页面。Obsidian 是 IDE,LLM 是程序员,wiki 是代码库。」 下面我们就照这个姿势来。
为什么维护 wiki 这件事人做不下去、模型却可以?Karpathy 的回答是:知识库最累的部分不是读和想,是记账——更新交叉引用、保持摘要同步、注意新数据是否推翻旧结论、在几十个页面之间保持一致。人会厌倦,维护成本涨得比价值快,所以 wiki 总是烂尾。模型不会腻、不会漏掉一处引用,一次能改 15 个文件,维护成本接近零。
3. 动手:让 Codex 把一万个孤点织成网
3.1 给 Codex 装上 Obsidian skill
Codex 默认并不知道 Obsidian 特有的语法([[双链]]、![[嵌入]]、> [!warning] callout、笔记属性)。kepano(Obsidian 的 CEO)维护了一套 obsidian-skills,装法就是把它的 skills/ 目录拷到 Codex 的技能目录:
git clone --depth 1 https://github.com/kepano/obsidian-skills /tmp/obsidian-skills
mkdir -p ~/.codex/skills
cp -r /tmp/obsidian-skills/skills/* ~/.codex/skills/
ls ~/.codex/skills
# defuddle  json-canvas  obsidian-bases  obsidian-cli  obsidian-markdown
其中 obsidian-markdown 是这次真正用到的:wikilink 的四种写法、属性(frontmatter)的类型、callout 的语法都在里面。Codex 开工前会自己把它读一遍——它跑的第一条命令就是 sed -n '1,240p' ~/.codex/skills/obsidian-markdown/SKILL.md。
3.2 把 idea file 交给 Codex,加上我们自己的约束
Karpathy 那份文档本来就是设计成「贴给 agent」的,所以 prompt 的主体就是它的原文,前面加了这次任务的约束:
raw/一个字节都不许改、不许移动、不许删。- 全部用简体中文写,文件名也用中文;wiki 页名全库唯一,文件名不含 Obsidian 不允许的字符。
- 可以在库里建
.venv装jieba之类的包写工具,放tools/。 - 无人值守,不要停下来问问题,遇到取舍自己决定并记进
log.md;预算 90 分钟,70 分钟就开始收尾。 - 一万篇一次做不完,所以分两层:精读层——真读原文、至少 40 篇、覆盖 6 个主题,写实体页 / 概念页 / 来源摘要页,跨来源交叉引用、发现矛盾要标出来;结构层——用工具批量建骨架(主题 → 子主题 / 实体 → 原文),让 ≥ 90% 的原文至少有一条来自 wiki 的入链。
- 最后 lint 一遍:坏链、孤儿页、重名页。
启动命令(Obsidian 就开着这个库,可以一边跑一边看):
cd /data/llmwiki-vault
codex exec --skip-git-repo-check -c 'sandbox_mode="danger-full-access"' "$(cat prompt-1-organize.md)"
3.3 Codex 做了什么
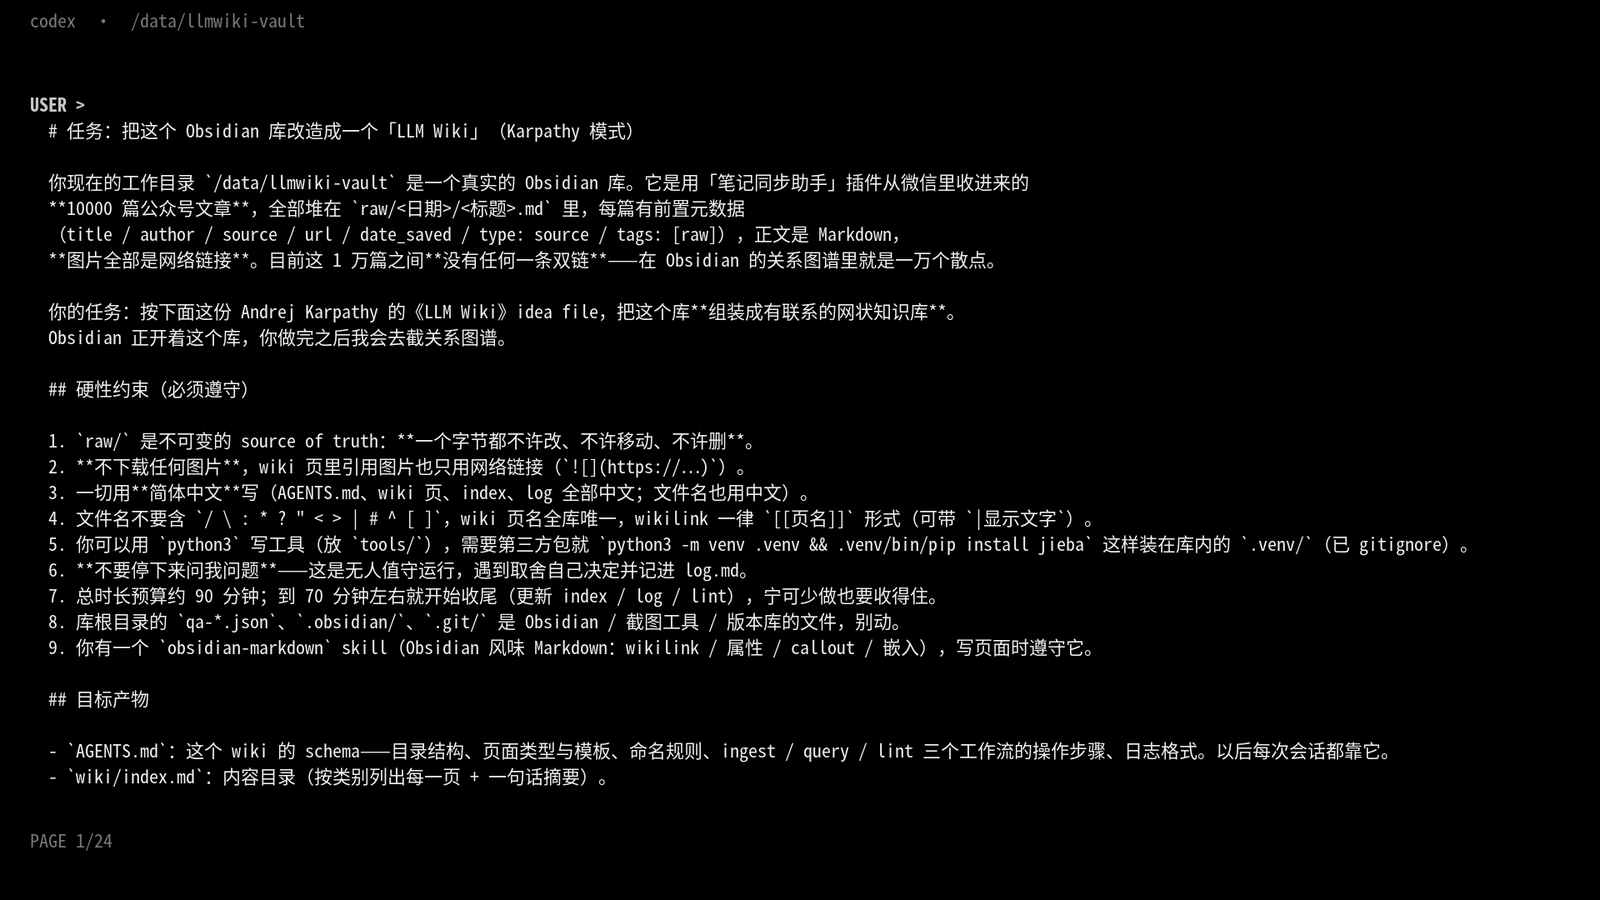
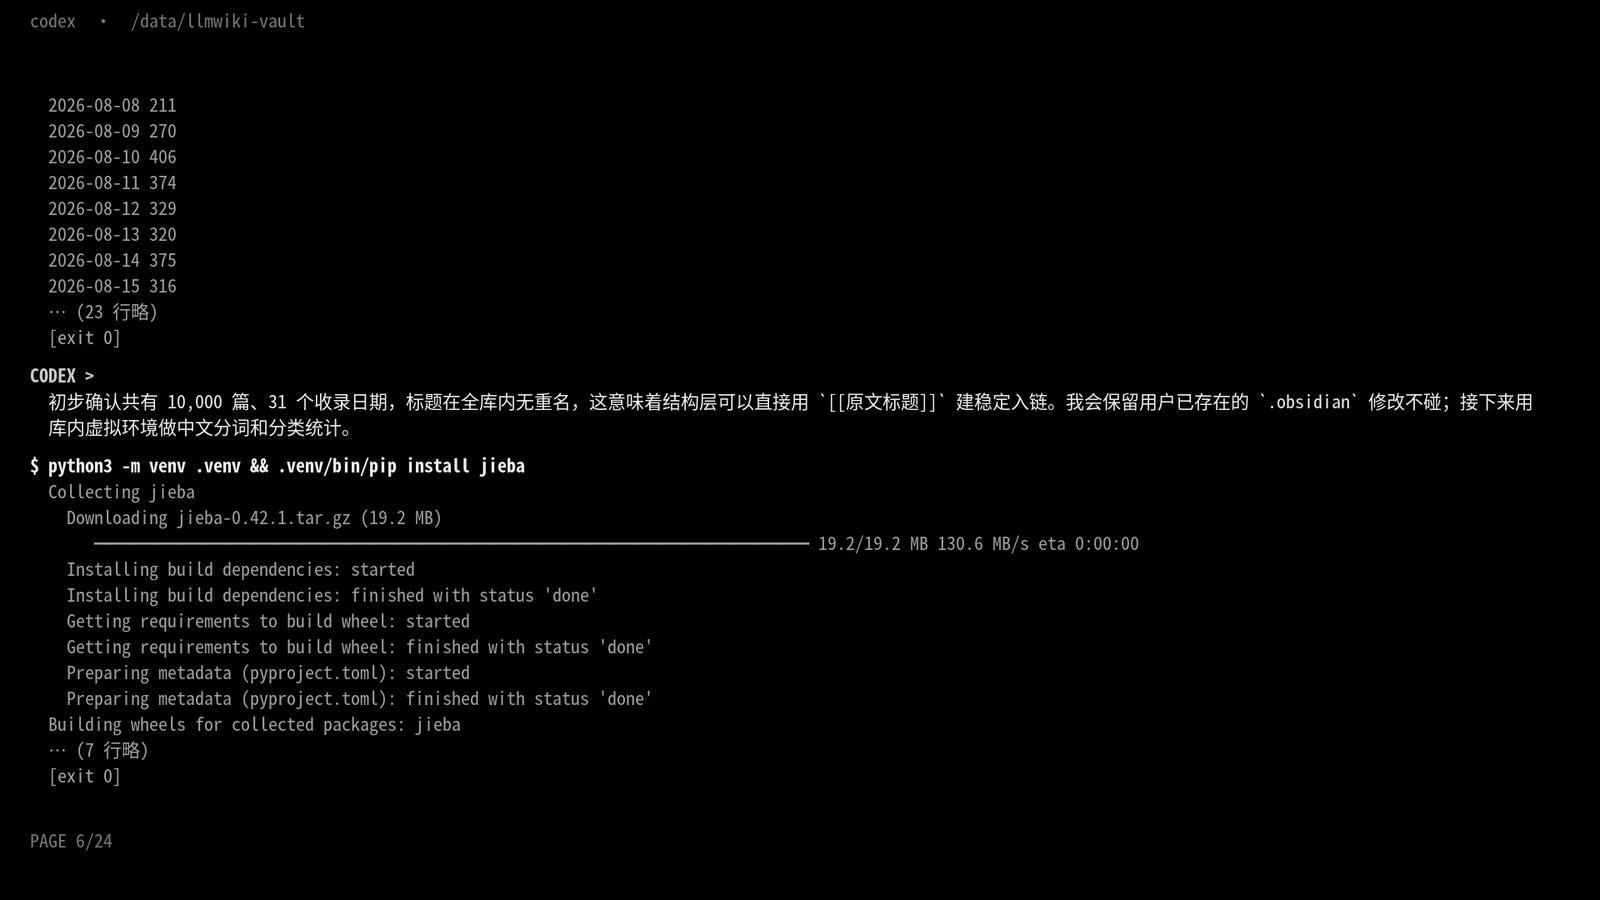
它开工的顺序很像一个谨慎的工程师:先读 skill,再只读地盘点 raw/(一万篇、31 个日期、标题无重名、共 133MB),然后——这一步我没要求——给一万个原文算了一遍 SHA-256 基线,说是为「raw 不可变」这条规则留证据,最后 lint 时会拿这份清单复核。接着在库里建 .venv 装 jieba 做中文分词。
然后它写了 AGENTS.md。这份 schema 完全由 Codex 起草,Obsidian 那边打开就能看到:
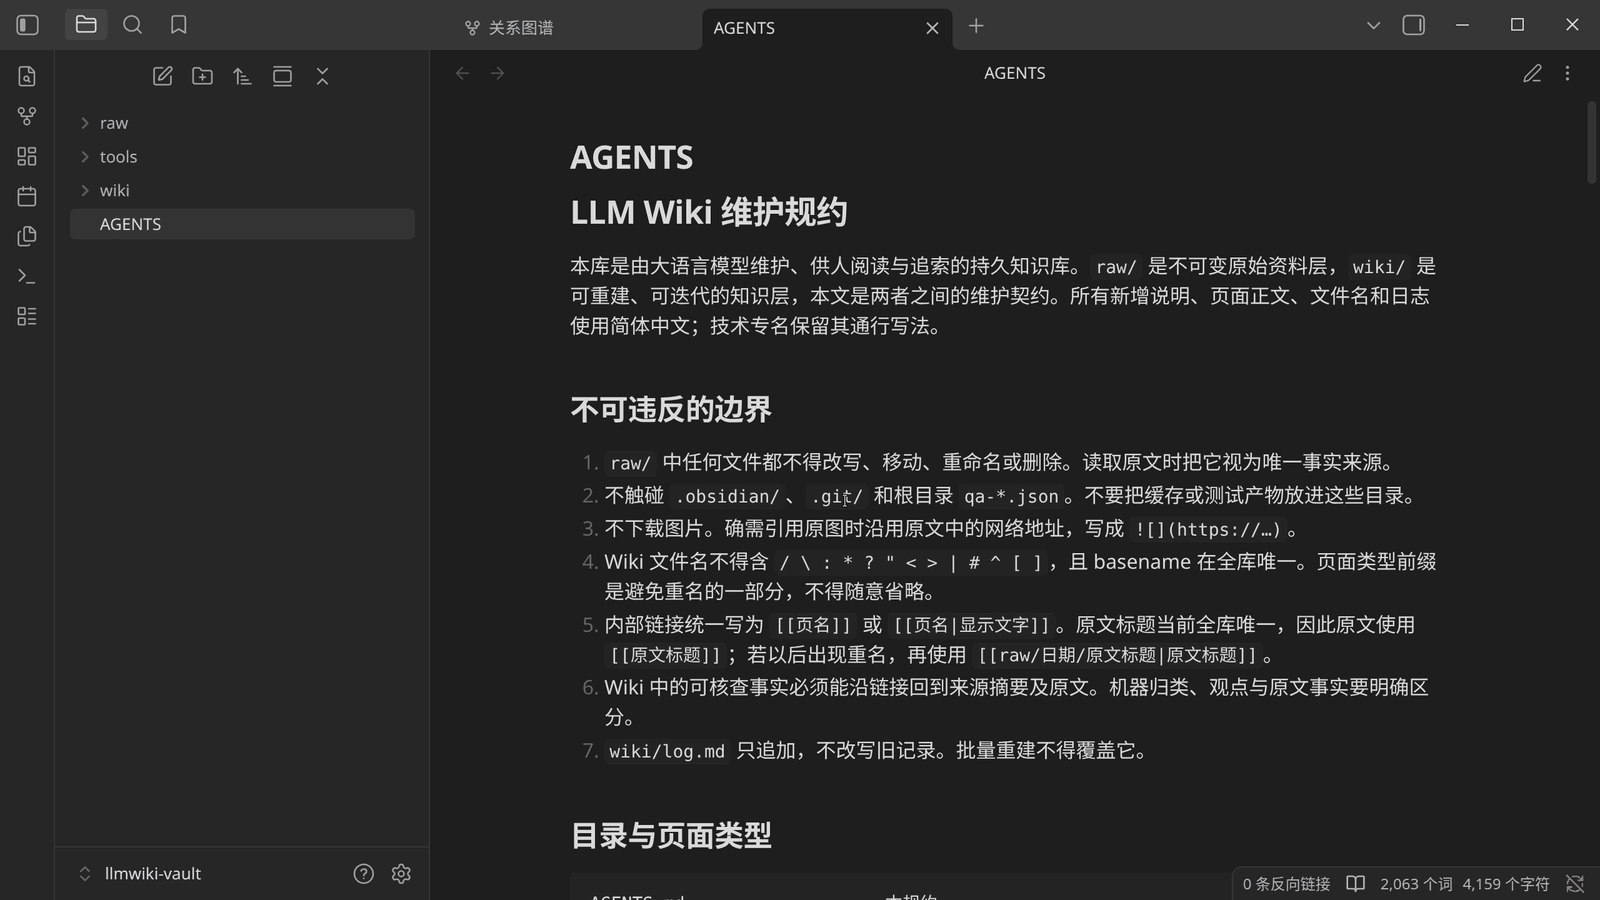
AGENTS.md 里值得一看的几处:
- 「不可违反的边界」:raw 只读、不碰
.obsidian/、文件名禁用字符、wikilink 写法、可核查事实必须能沿链接回到原文、log 只追加。 - 页面类型与命名:
主题 xxx/子主题 xxx/实体 xxx/概念 xxx/来源精读 001 xxx,每类一个前缀,靠前缀保证全库不重名;列表超过 200 条自动分页(实体 Anthropic 第01页)。 - 四个页面模板(主题页 / 聚合页 / 概念页 / 来源摘要页)——概念页固定有「跨来源综合」和一个
> [!warning] 来源分歧callout;来源摘要页固定有「核心判断 / 数据与细节 / 与库内知识的连接 / 可信度与待验证点」,并要求把「作者声称」和「已证实」分开。 - Ingest / Query / Lint 三个工作流的操作步骤,以及日志的固定五项:范围、动作、结果、取舍、后续。
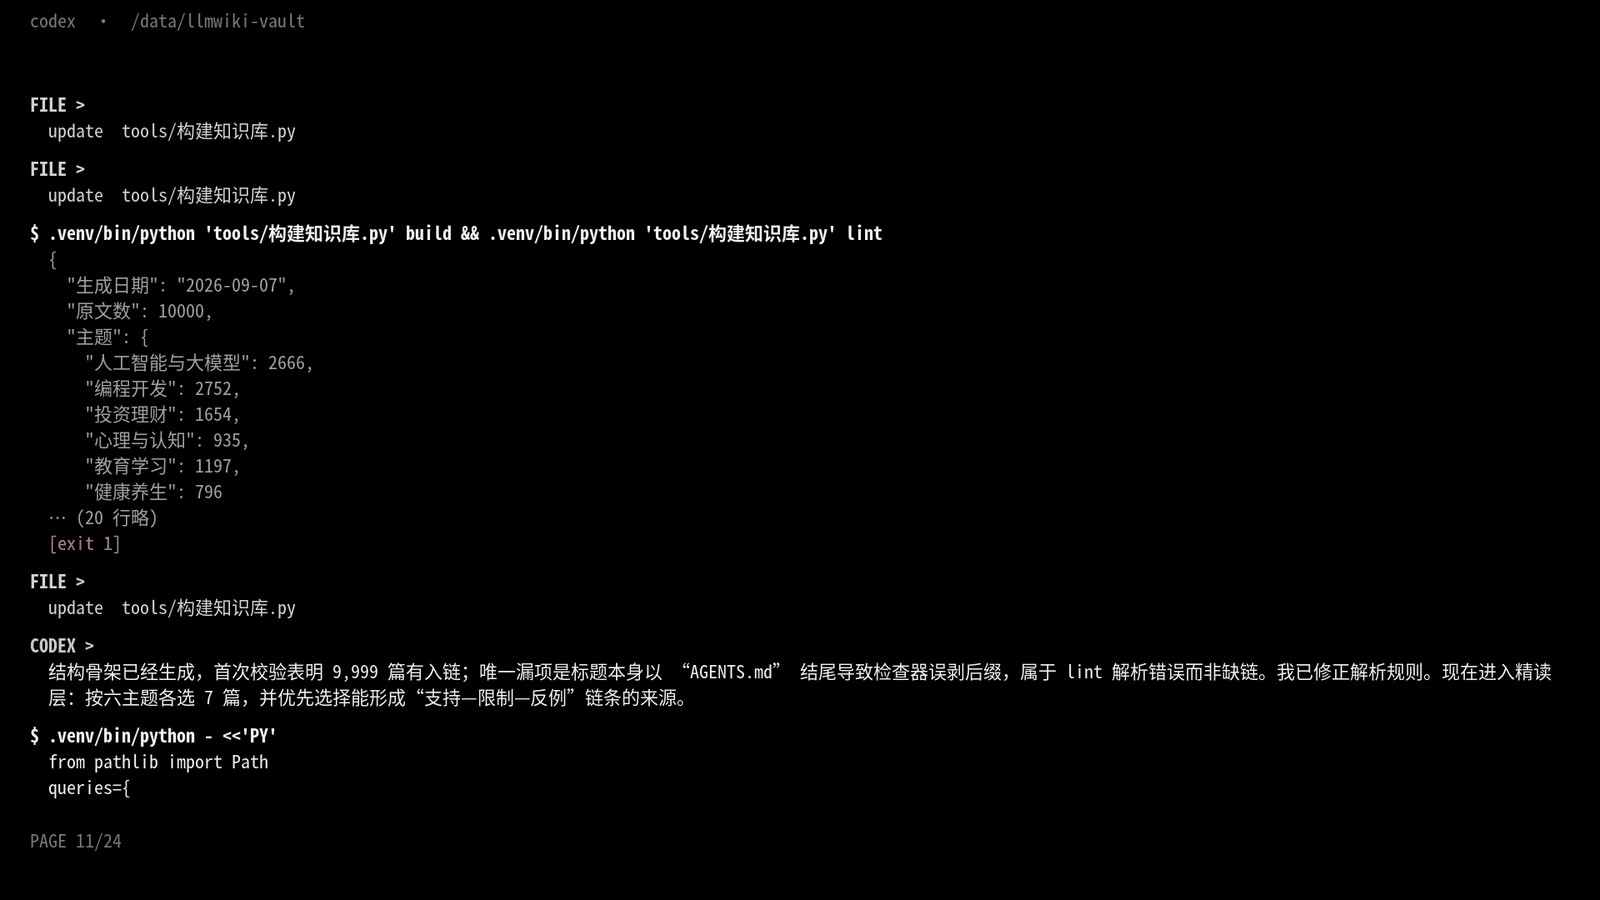
接下来是结构层。它写了一个 40KB 的 tools/构建知识库.py(analyze / build / lint 三个子命令),用分词 + 标题信号把一万篇归进 6 个主题、62 个子主题,找出 48 个高频实体(公司 / 产品 / 模型 / 人),生成聚合页。第一次 lint 报 9,999/10,000 篇有入链——漏的那一篇是因为标题本身以「AGENTS.md」结尾,被检查器当成后缀剥掉了;它修了 lint 的解析规则,而不是去动原文。
然后是精读层:六个主题各挑 7 篇、共 42 篇,真的读全文,写成 42 篇来源精读页 + 22 个概念页,并把「支持 — 限制 — 反例」的链条连起来。它在中途自己汇报的一句话很能说明这一层在干什么:
精读正在形成几条真正的跨来源主线,而不是 42 篇孤立摘要:例如「LLM Wiki 的复利价值」同时受到成本、失真和 provenance 问题约束;「模型更强」并不能替代 Harness、测试、权限和外部不变量;因果推断文章则会与量化回测、教育效果和精准营养交叉连接。
47 分钟后收工。最终数字(来自它自己的总结和最后一次 lint):
| 项目 | 结果 |
|---|---|
| wiki 页面 | 394 页:6 主题、62 子主题、48 实体、42 来源精读、22 概念,加分页 / 总览 / 目录 / 日志 |
| Wikilink 总数 | 43,870 条 |
| 原文入链覆盖 | 10,000 / 10,000(100%) |
| lint | 坏链 0、孤儿 0、重名 0、非法文件名 0、超长列表 0 |
| raw 是否被动过 | SHA-256 清单前后一致,没动 |
| token | 输入 592 万(其中 569 万命中缓存)、输出 7.4 万 |
3.4 整理后的关系图谱
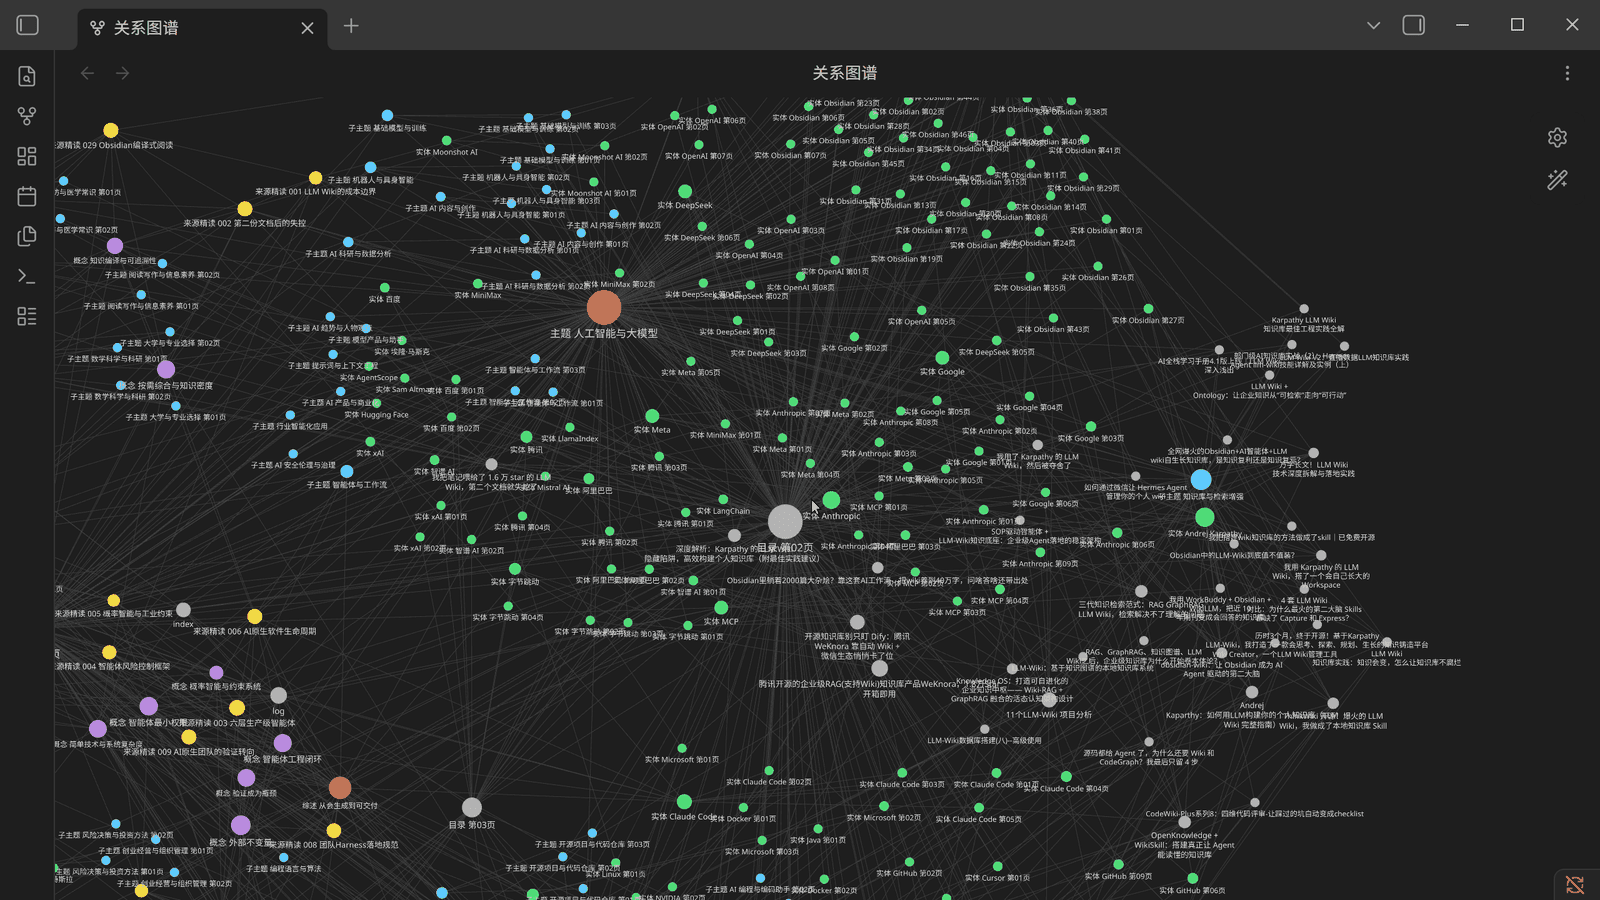
再打开关系图谱,同一万篇文章变成了这样。为了看得清层次,我在图谱设置的「颜色组」里按路径给了颜色:path:wiki/topics 橙、path:wiki/subtopics 蓝、path:wiki/entities 绿、path:wiki/concepts 紫、path:wiki/sources 黄。
放大看,每一个蓝点 / 绿点周围都挂着几十上百篇原文;右下角那一小撮紫色和黄色,是精读层——概念页和来源精读页互相连得很密,那是 Karpathy 说的「交叉引用已经在那儿了」。
在筛选里填 path:wiki,只看 wiki 层的 395 页,骨架就露出来了:橙色主题页在中心,蓝色子主题页和绿色实体页围一圈,紫色概念页和黄色来源精读页在右下角自成一团——这就是「总览 → 主题 → 子主题 / 实体 → 原文」那个分层结构本身。
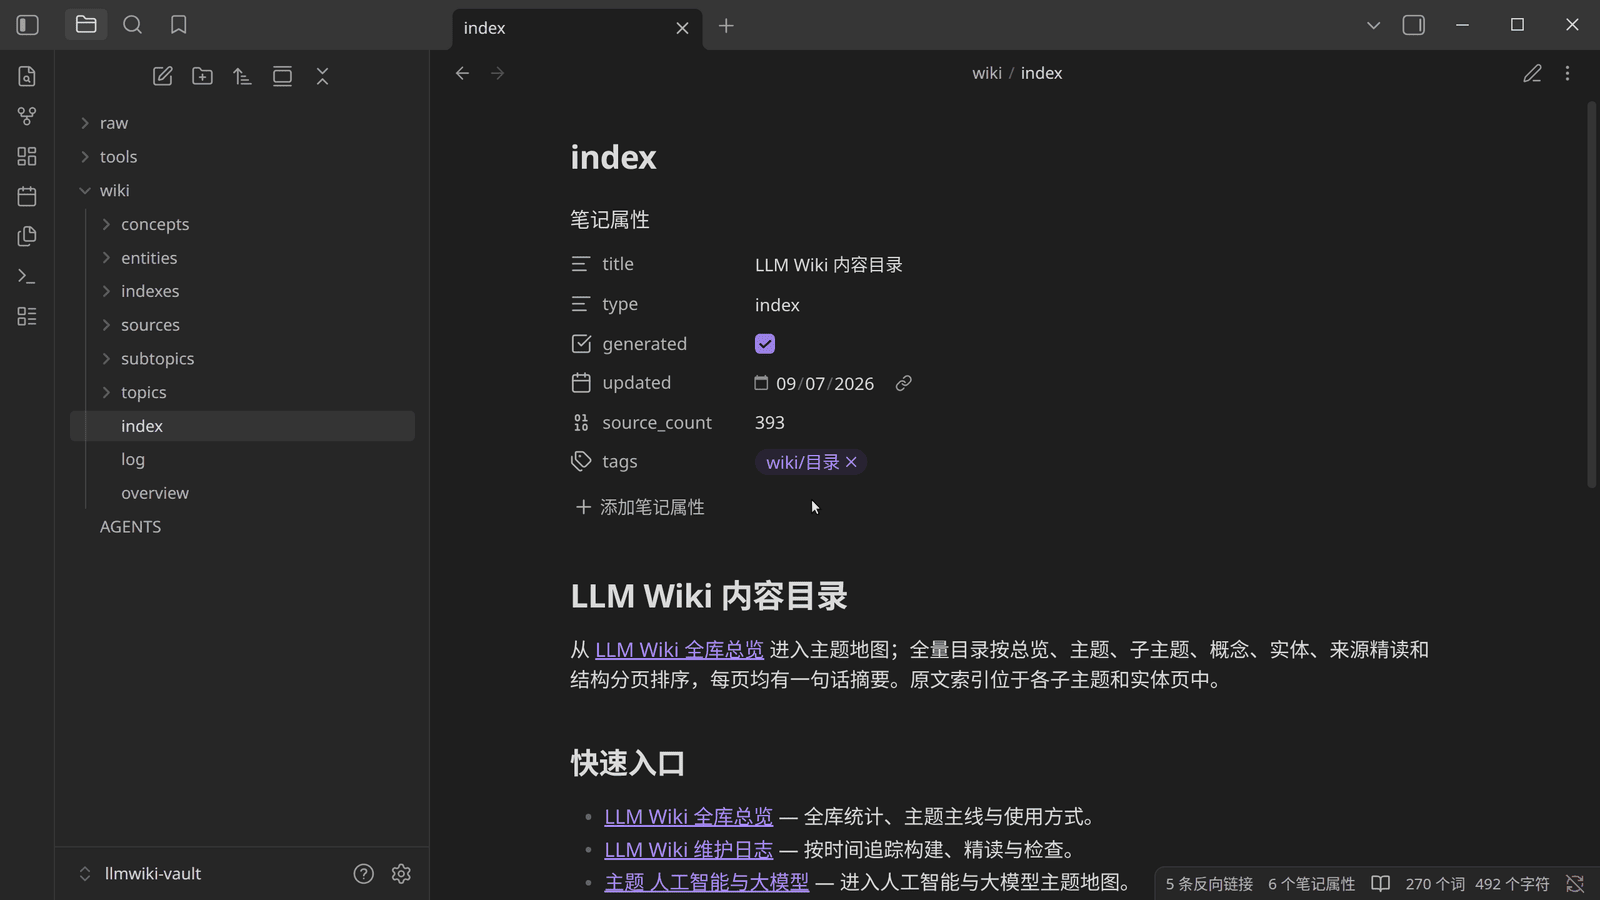
图谱之外,几个页面长这样。index.md 是全库目录,overview.md 是总览(主题分布表 + 各主题最大的三个子主题):
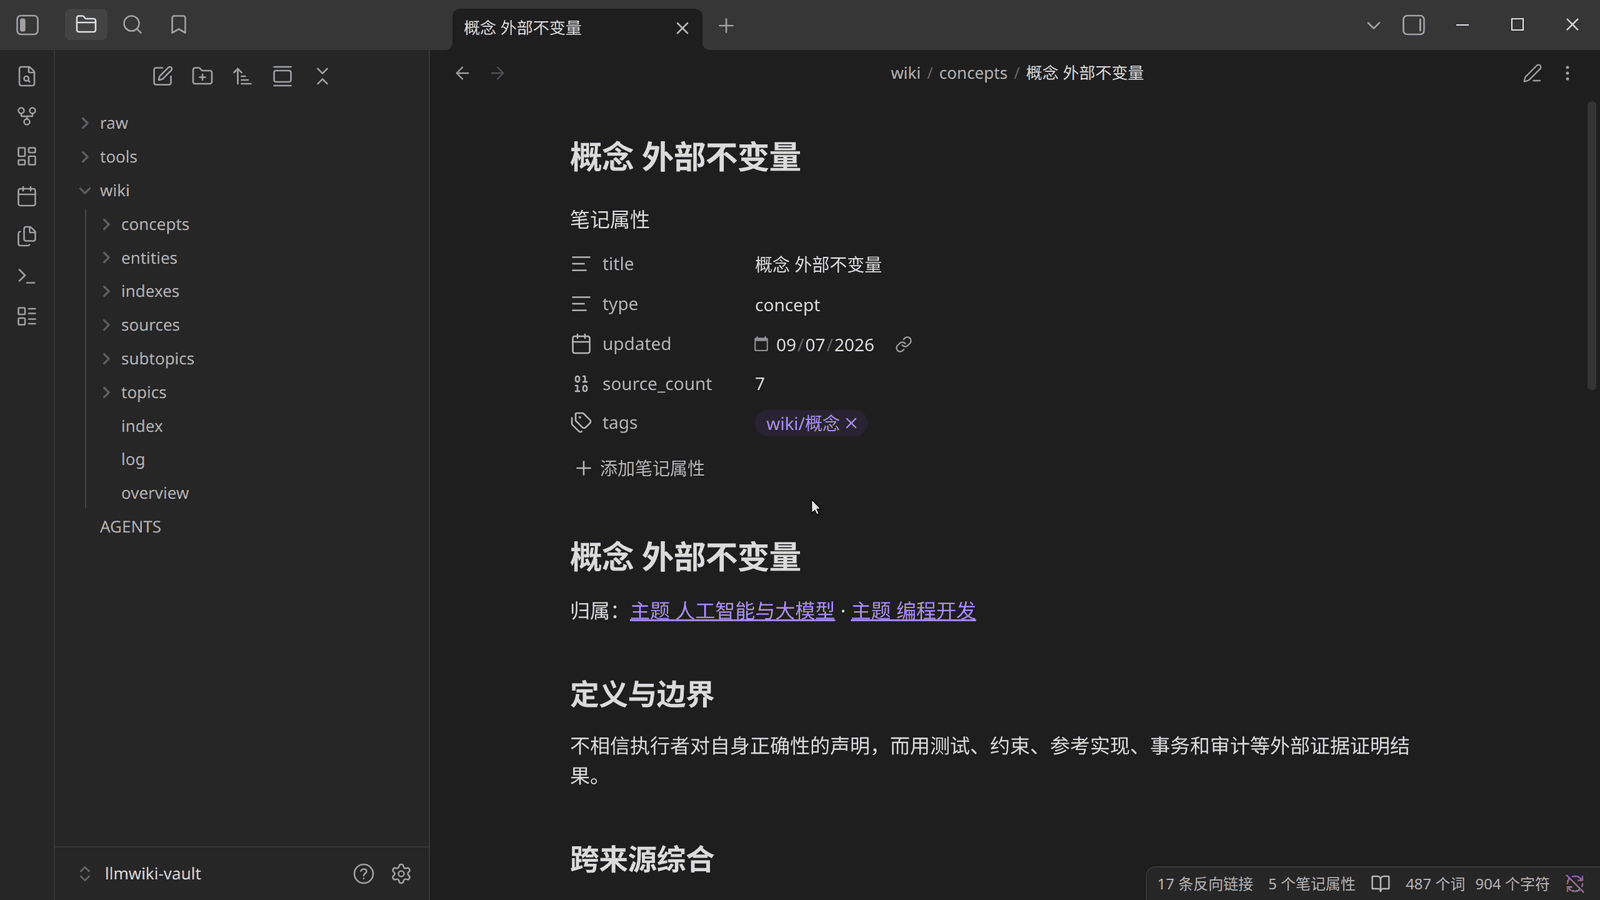
一个概念页——「外部不变量」,由 7 篇来源精读支撑,正文分「定义与边界 / 跨来源综合 / 来源分歧 / 证据链 / 相关概念」,每条证据都能顺着 来源精读 → 原文 两跳回到原文:
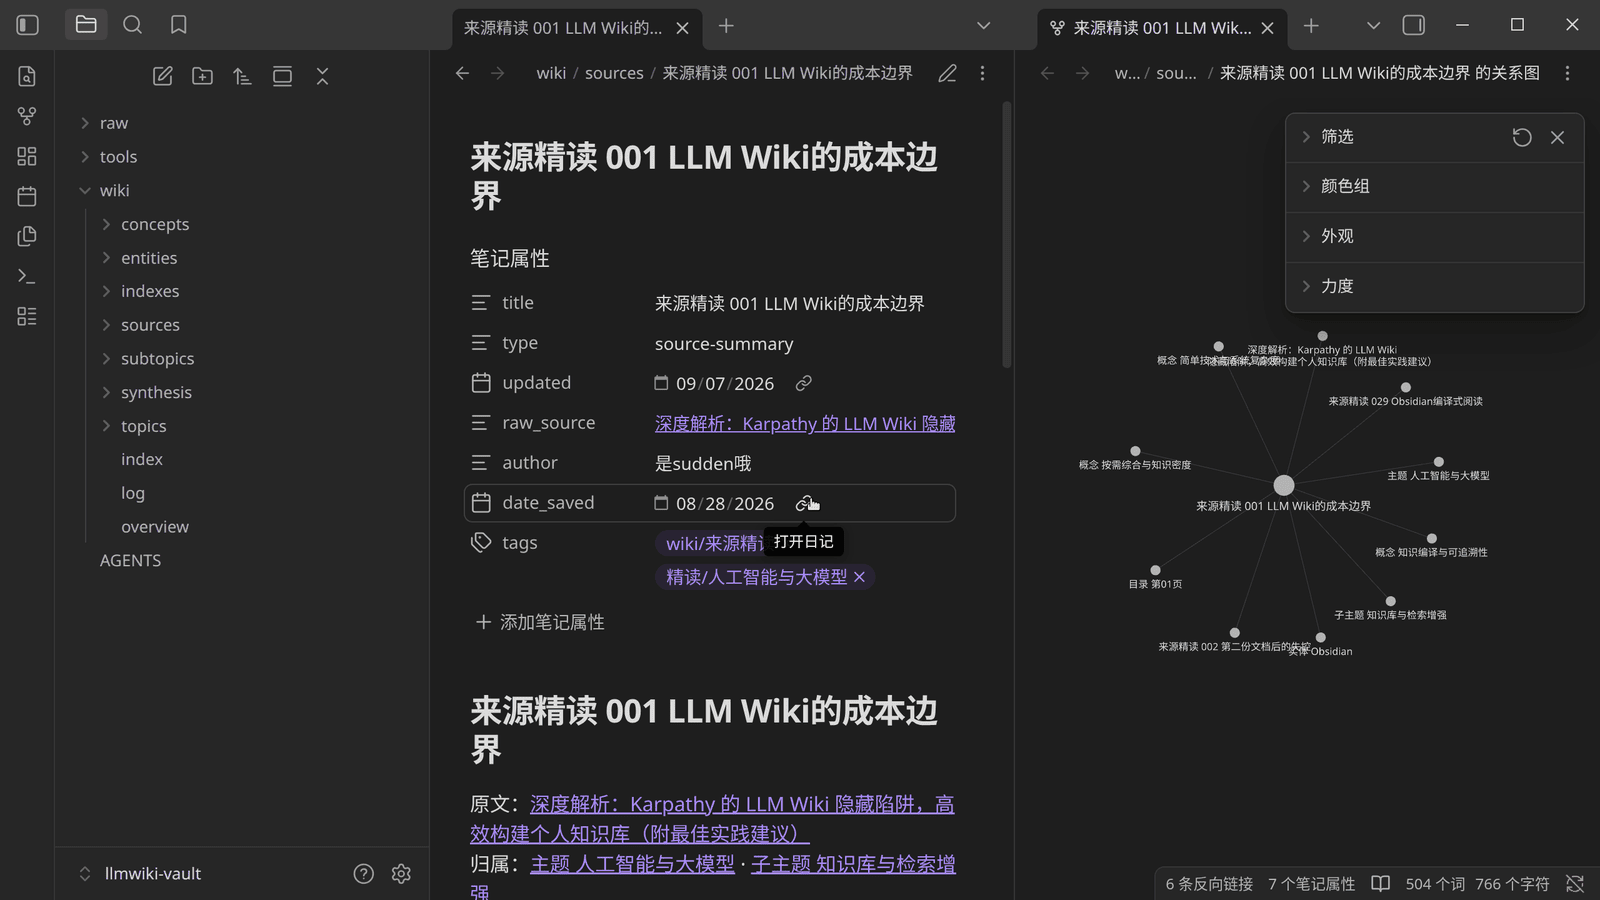
一个来源精读页和它的局部关系图。这篇精读的原文恰好是一篇讨论 LLM Wiki 成本陷阱的文章——Codex 把作者自报的 token 数和费用记进了「数据与细节」,又在「可信度与待验证点」里注明「单一作者自测、依赖当时价格、不能直接外推」。右边的局部关系图能看到它向上连着两个概念页、一个实体页、另外两篇精读,向下连着原文:
4. 应用:让 Codex 基于这个库写一篇综述
wiki 建好之后,真正的收益在 Query。这次让 Codex 就「AI 智能体生产化与验证」这个主题,基于库里的内容写一篇综述。硬要求是:3000–5000 字,至少 40 条不同的 [[双链]],覆盖 ≥ 10 篇原文、≥ 5 个实体页、≥ 3 个概念页;原文事实、跨来源综合、模型推论在文字上要分开;有分歧的地方用 callout 并列写出两边口径。
它先读 AGENTS.md、index、overview 和 log 的最近几条,从 index 找到相关的主题页和概念页,再顺着概念页下钻到 12 篇来源精读和它们的原文。这个主题能沿概念页横跨 Agent、工业控制、Linux、编译器和数据库,沿实体页回到 Anthropic、Claude Code、MCP、GitHub 的具体实践——每个分论点里双链都有解释力。
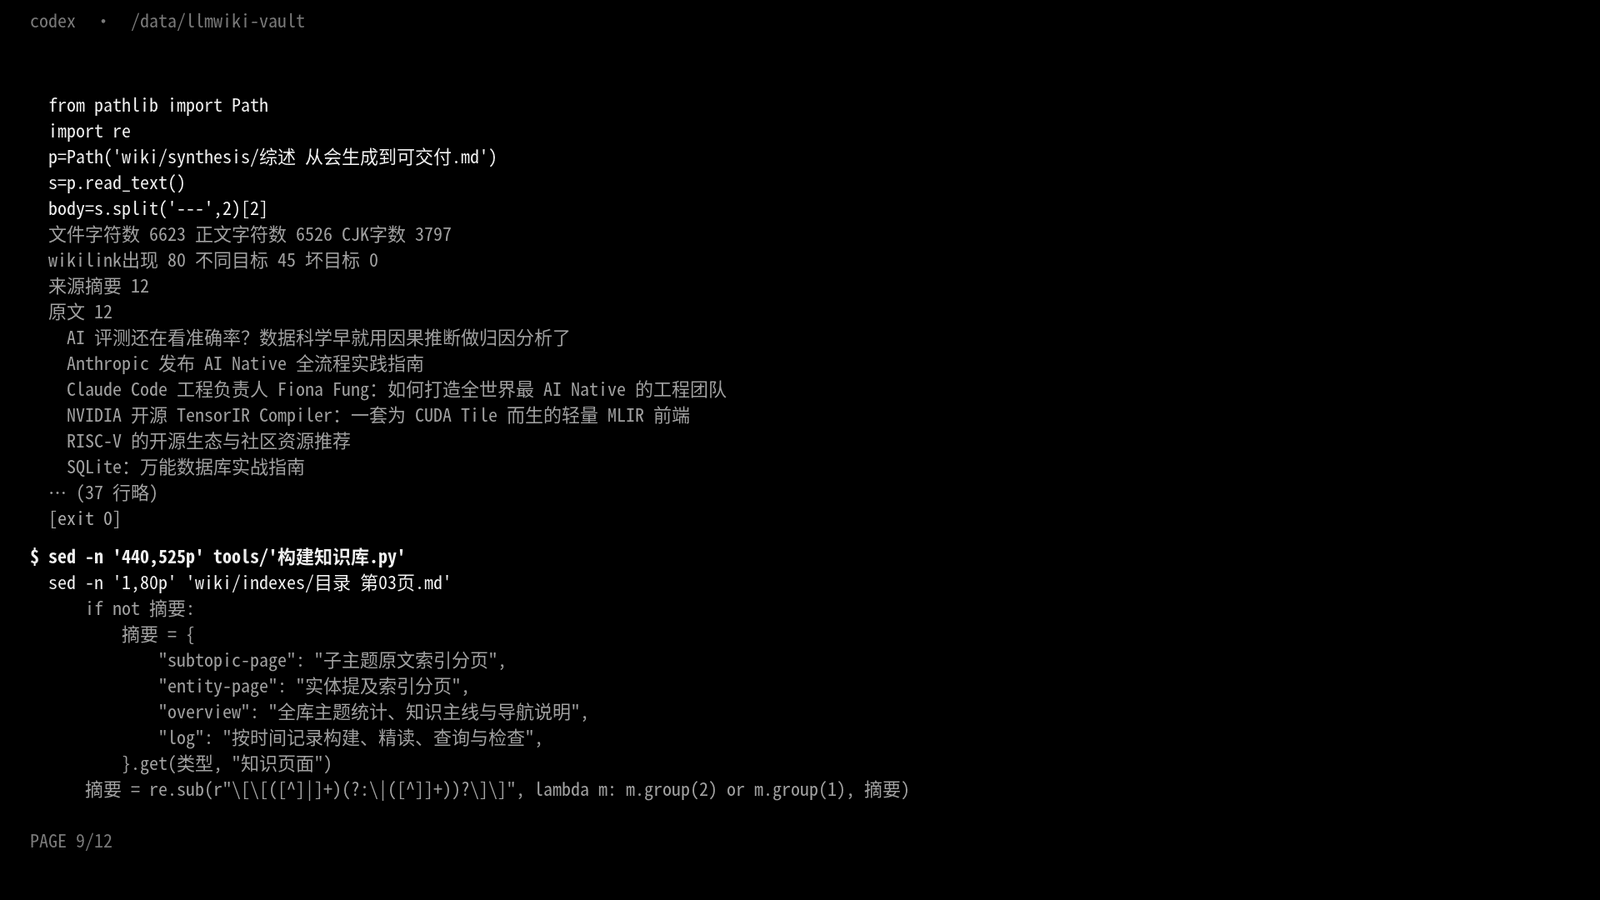
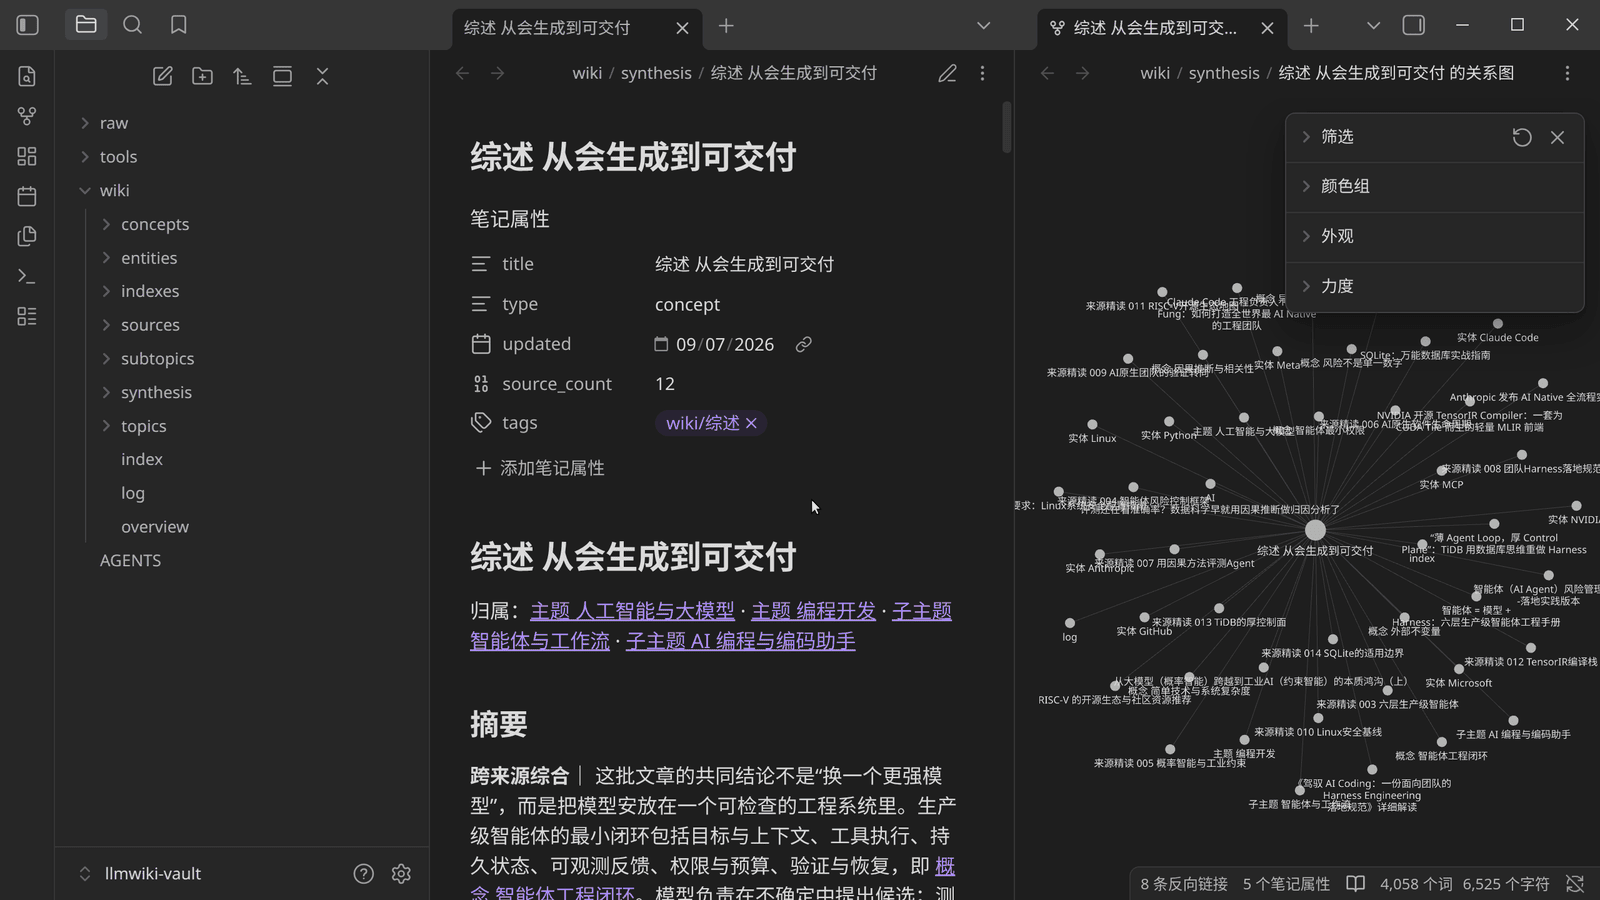
16 分钟后交稿:wiki/synthesis/综述 从会生成到可交付.md,3,797 个汉字,80 次双链引用、45 个不同目标,覆盖 12 篇来源精读、12 篇原文、9 个实体页、8 个概念页,4 个来源分歧 callout。结构是摘要 → 时间线 → 四个分论点(可靠性重心从模型转向 Harness / 生成越快验证越是瓶颈 / 权限状态恢复必须独立于模型意志 / 简单性是把复杂度放在正确的层)→ 来源立场对比表 → 五个待验证问题 → 参考。交稿前它自己数了一遍字数、双链数和覆盖的来源:
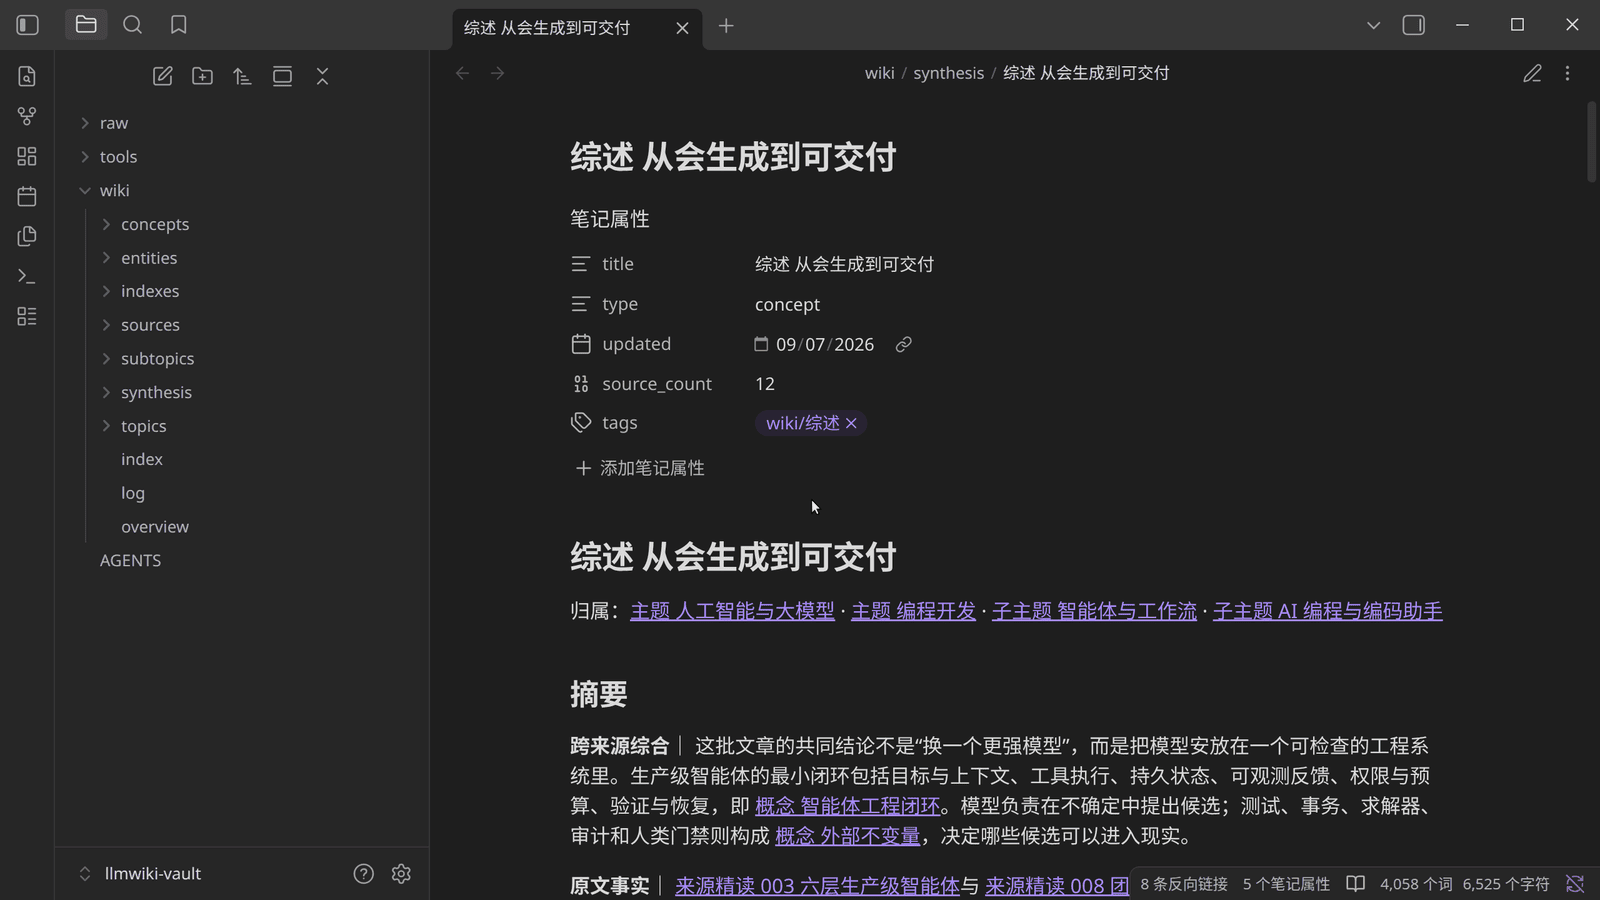
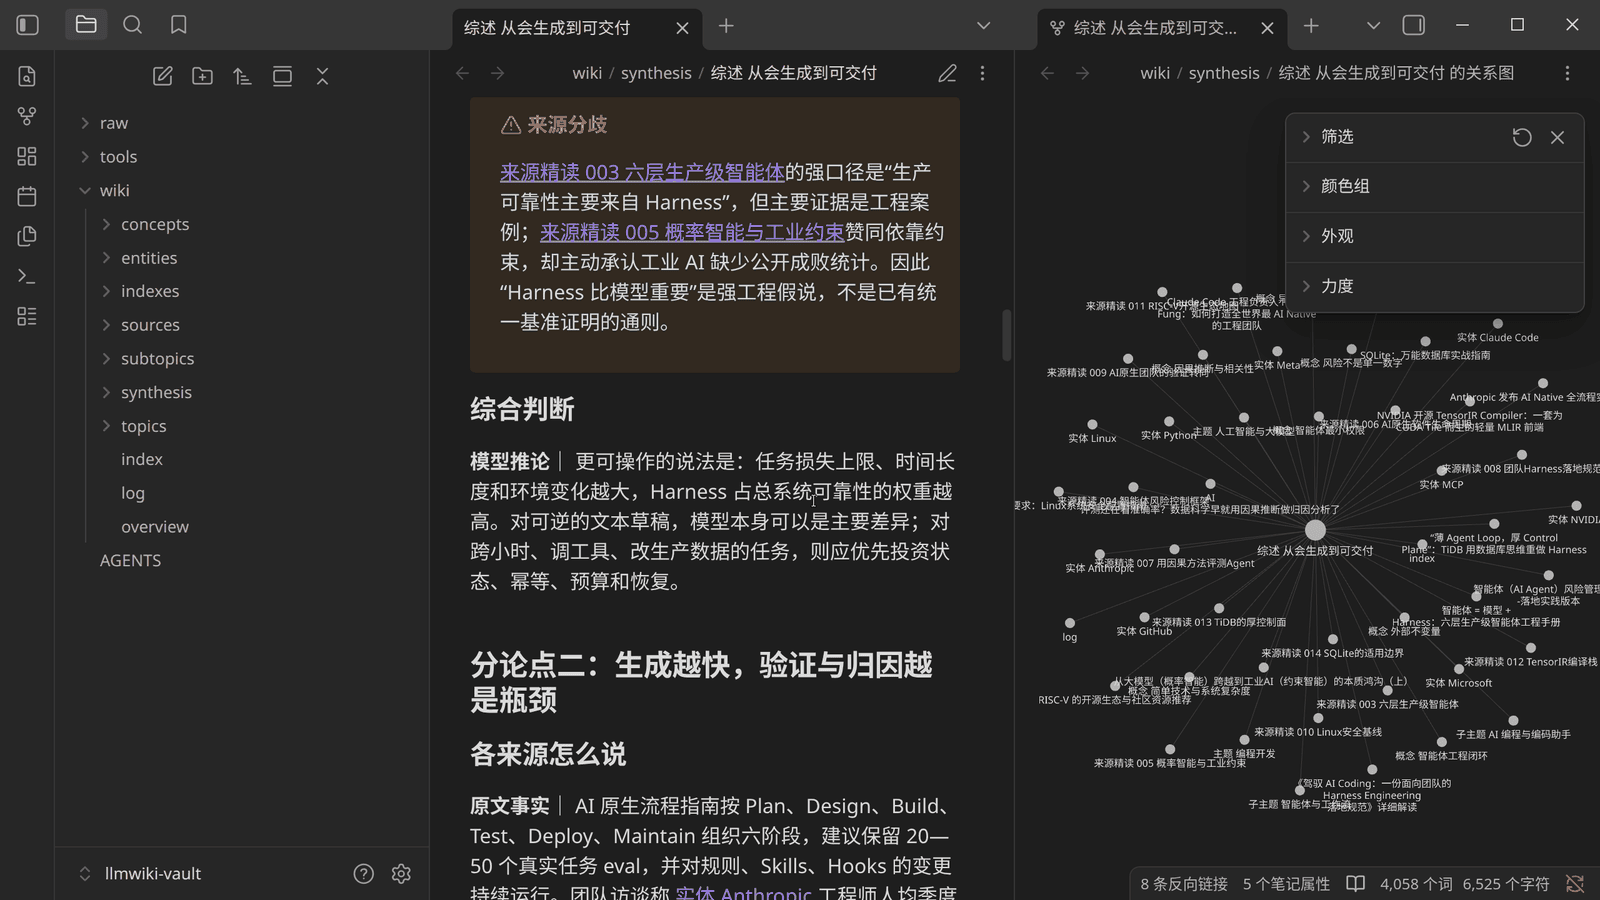
每一段都标了是「原文事实」「跨来源综合」还是「模型推论」,这是 AGENTS.md 里定的规矩,读的人一眼能分清哪句话能追到原文、哪句话是模型自己的判断。分歧用 callout 并列写出两边口径,各自链到来源精读:
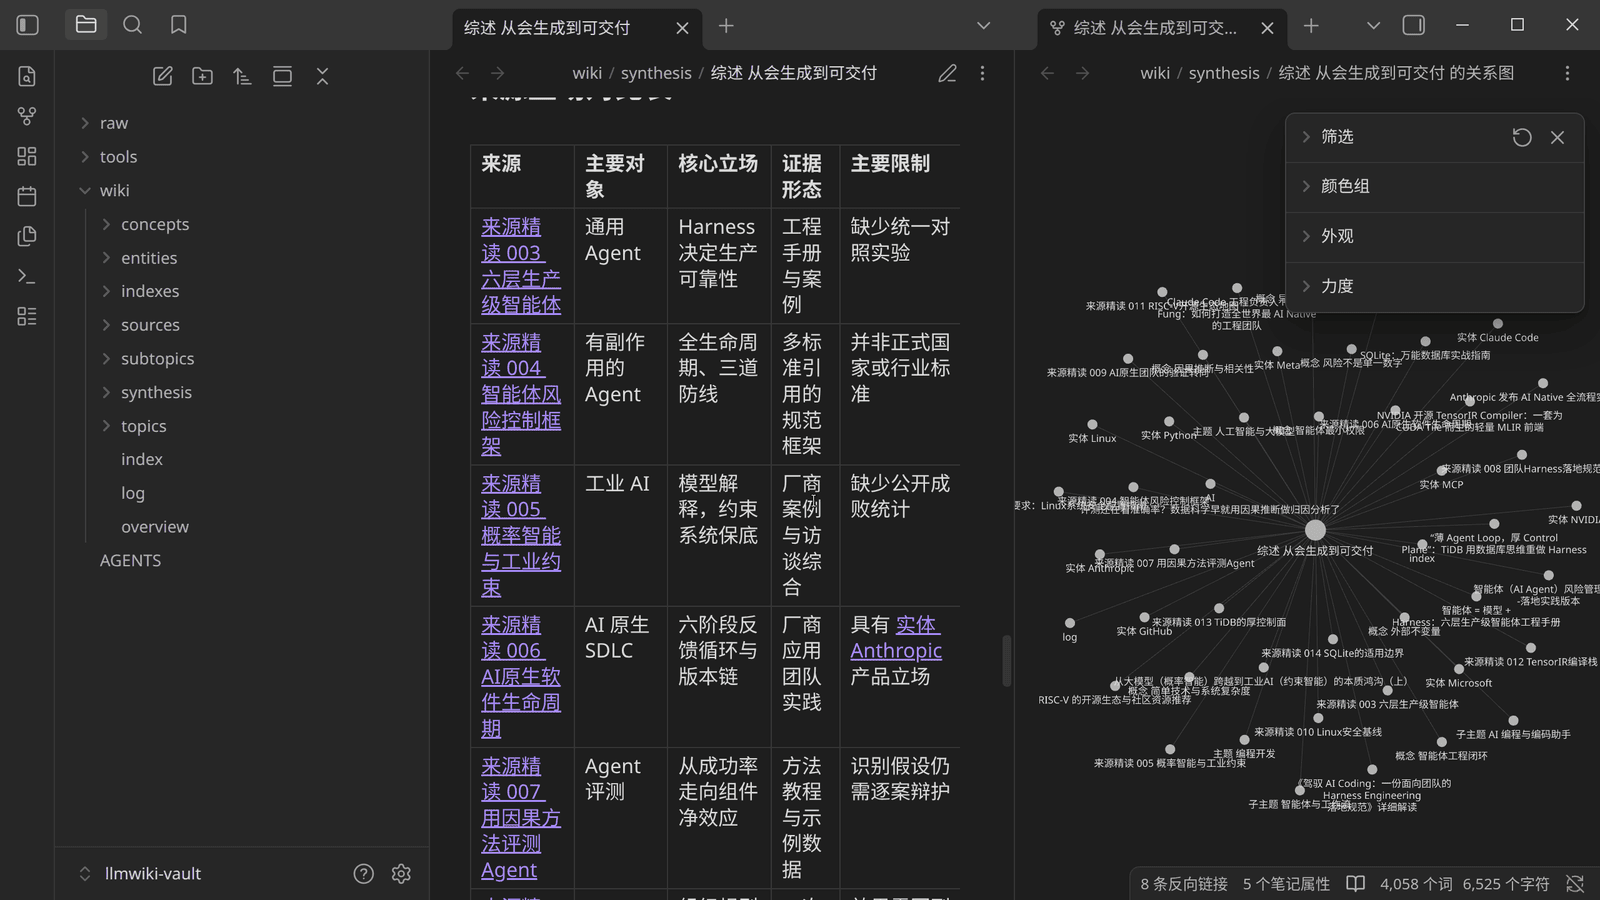
来源立场对比表——每一行的第一列都是双链,点进去是来源精读页,再点一下是原文:
综述页的局部关系图。中间是综述本身,一圈是它引用的来源精读、概念、实体和原文——这就是「充分利用双链」的字面形状:
Codex 自己觉得最有意思的一处分歧:Claude Code 团队访谈里说工程师人均提交量约为以前的 8 倍,而另一篇讲因果评测的文章正好提醒,没有质量、用户价值和反事实对照,活动量增加不能证明生产率提升 8 倍——两篇文章的作者互不认识,是 wiki 把它们放到了同一个 callout 里。这正是 Karpathy 说的「矛盾已经被标出来了」。
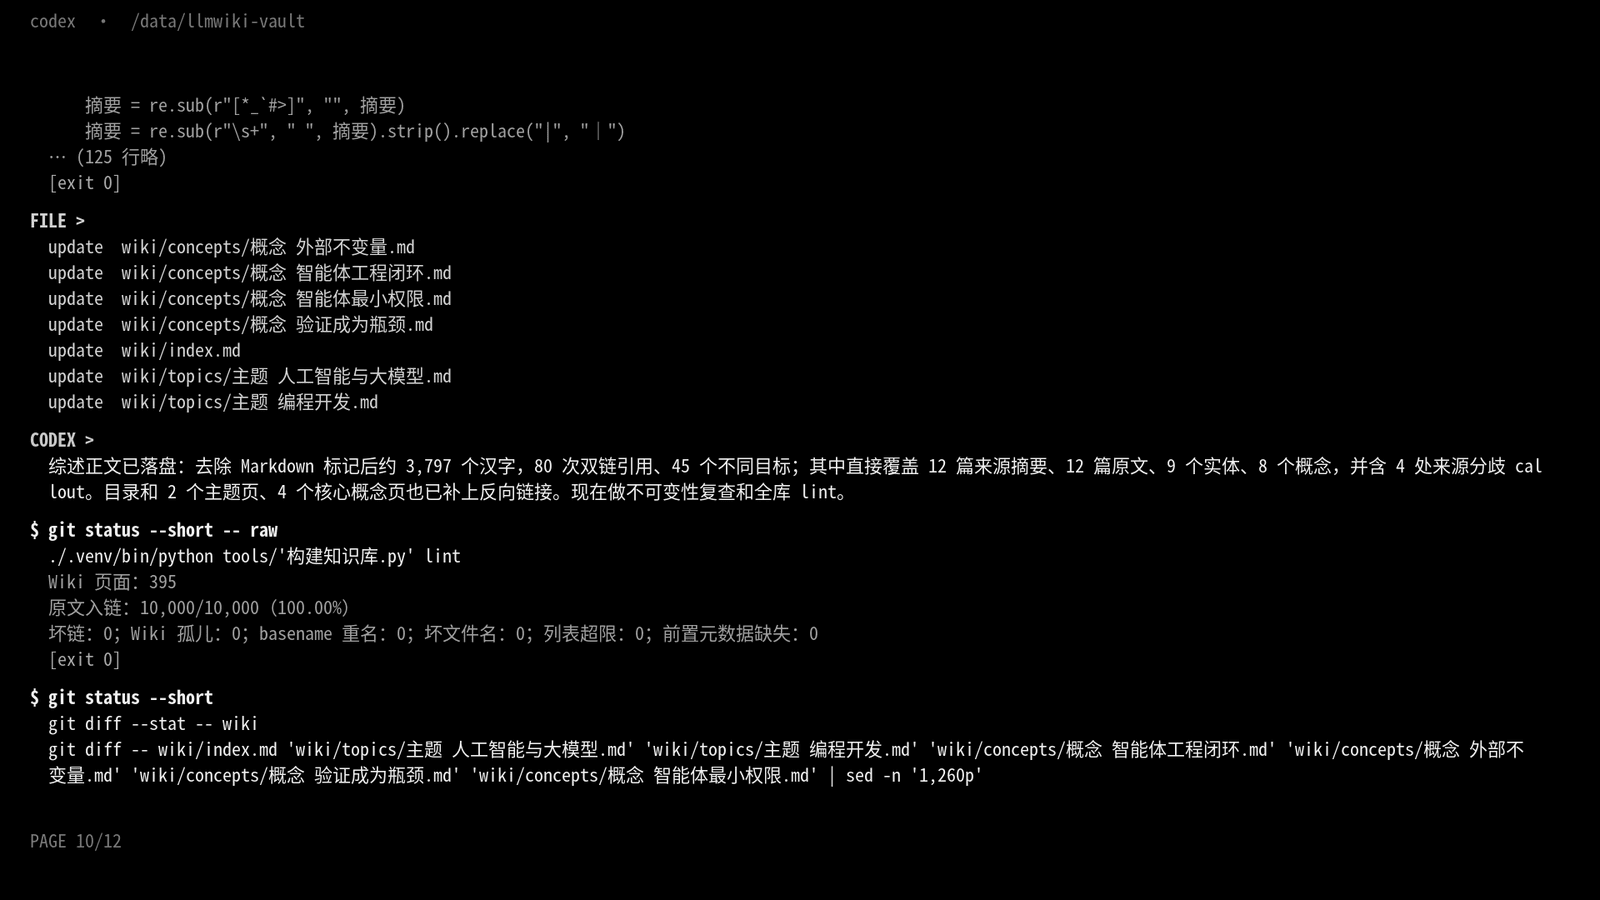
这篇综述本身也被 file 回了 wiki:登进了 index.md,两个主题页和四个概念页加了指回它的链接,log.md 多了「综述」和「lint」两条记录。下次再问相关问题,Codex 会先读到它。
5. 让新文章自动进网:笔记同步助手怎么配
到这里 wiki 已经跑起来了,但它只覆盖了「现在这一万篇」。以后随手转发给「笔记同步助手」的文章,要能自动落到 raw/ 里、带着和现有文章一样的属性,Codex 才能直接对它们做 ingest。这一步全在插件设置页里,四个地方:
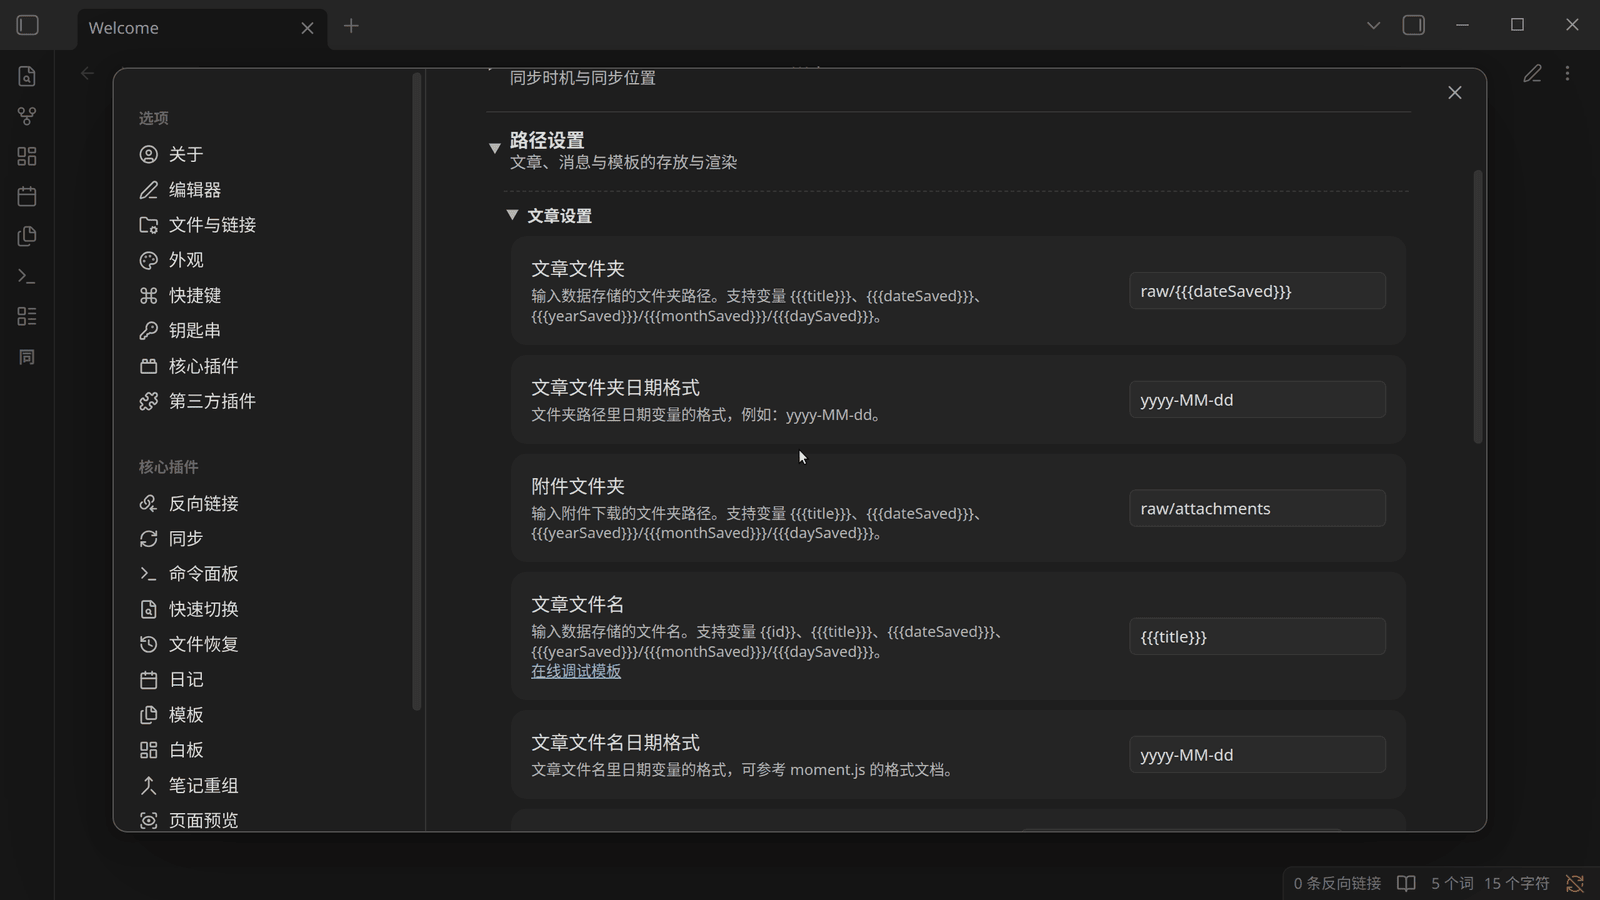
① 路径设置 → 文章设置。 文章文件夹填 raw/{{{dateSaved}}},日期格式 yyyy-MM-dd,文章文件名 {{{title}}}。这样新文章会落成 raw/2026-09-08/<标题>.md,和现有的一万篇同一个布局。附件文件夹顺手改成 raw/attachments,别让它落到 wiki 里。
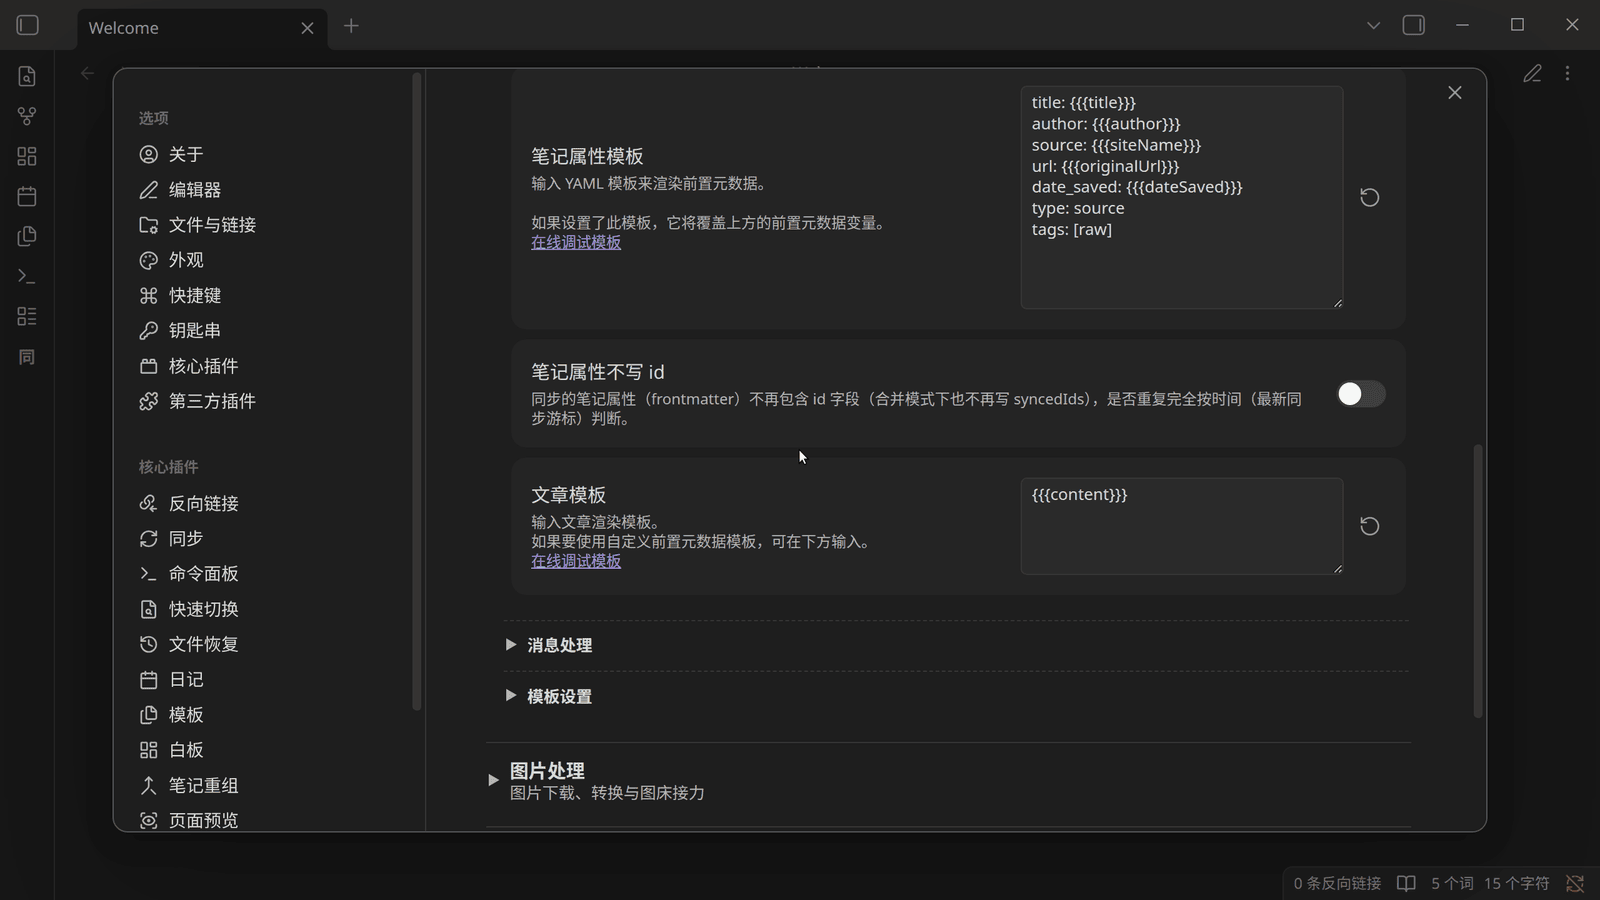
② 笔记属性模板。 填成和现有原文一样的 YAML,让 Codex 的工具和 schema 能按同一套字段识别新来源:
title: {{{title}}}
author: {{{author}}}
source: {{{siteName}}}
url: {{{originalUrl}}}
date_saved: {{{dateSaved}}}
type: source
tags: [raw]
type: source 和 tags: [raw] 是给 LLM 看的标记——AGENTS.md 里约定了 raw 层的页面就长这样,wiki 层的页面 type 是 topic / concept / entity / source-summary 之类,一眼能分开。
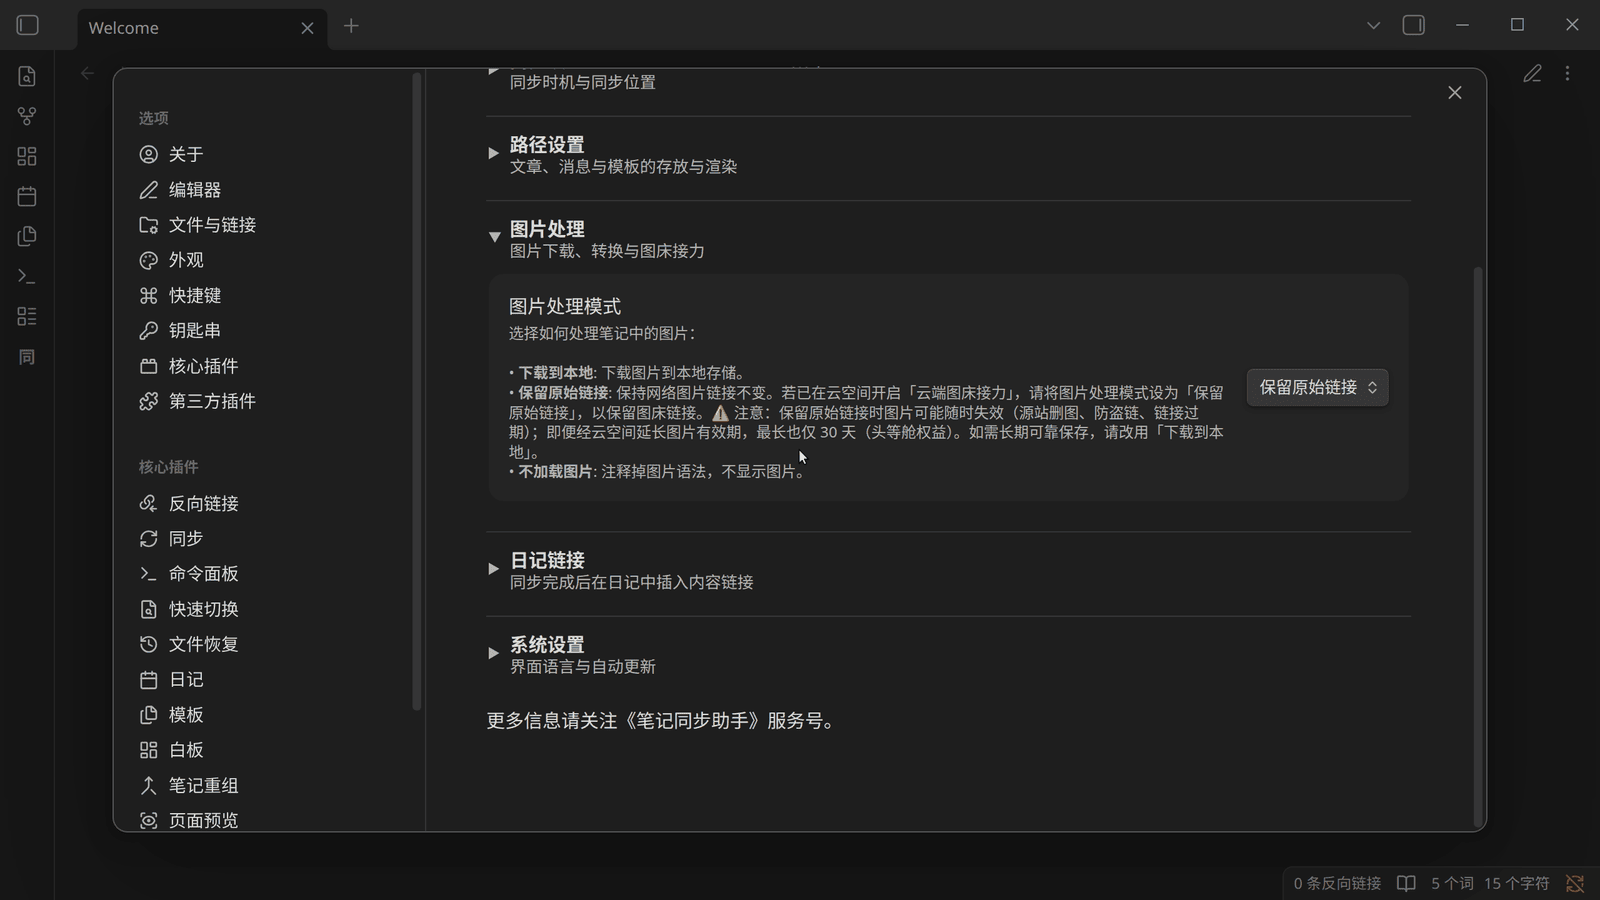
③ 图片处理 → 图片处理模式。 想让图片长期可用、方便后续 wiki 引用,就选「下载到本地」,插件会把图片本地化到 raw/images/(只要不落进 wiki/,对 LLM Wiki 的结构没有影响)。选「保留原始链接」的话要注意设置页里的提示:网络图片最长 30 天有效期(头等舱权益)。
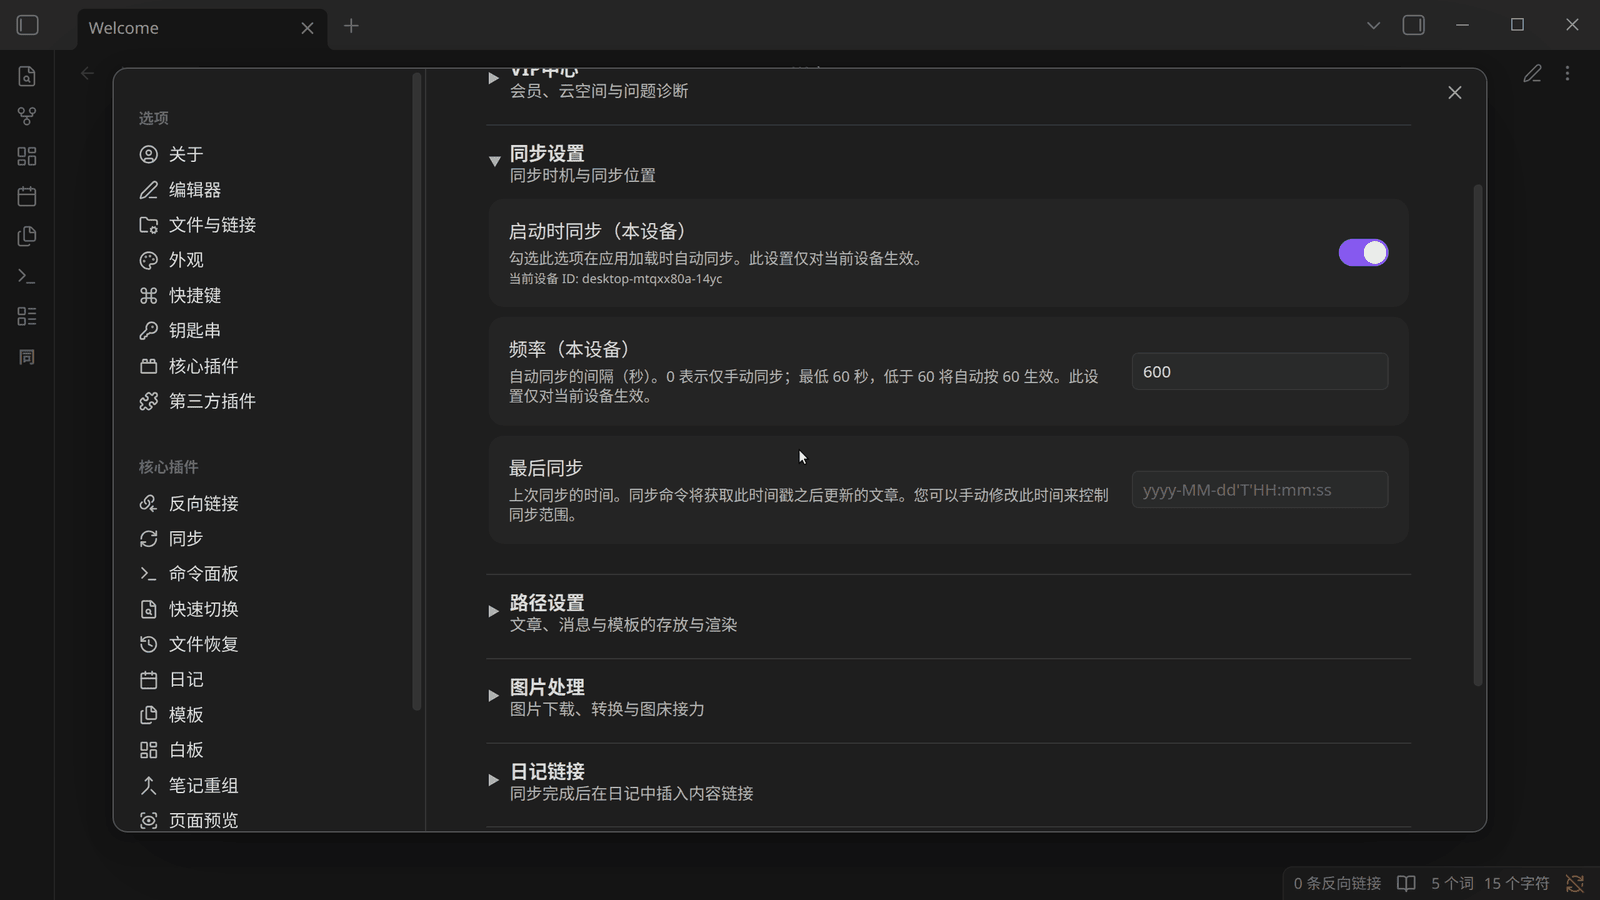
④ 同步设置。 打开「启动时同步」,频率填 600 秒(十分钟)。这样打开 Obsidian 就会把新保存的文章拉下来,之后每十分钟拉一次。
配完之后的日常流程就是 Karpathy 描述的那样:看到好文章 → 转发给笔记同步助手 → 它出现在 raw/今天/ → 对 Codex 说一句「ingest 今天 raw 里的新文章」→ Codex 按 AGENTS.md 里的 Ingest 工作流读原文、写摘要、更新实体页和概念页、登记 index、追加 log。你只负责挑文章和提问题。
6. 几点提醒
- 规模。 Karpathy 的模式是一篇一篇 ingest、人在旁边看。一万篇直接这么做既贵又慢,所以这次让 Codex 分了「精读层 + 结构层」两层:精读的 42 篇是真正意义上的 LLM Wiki,其余的靠工具挂进主题 / 子主题 / 实体骨架,先保证「每篇文章都能被找到」。之后每次 ingest 新文章,精读层会一点点长大。Codex 在总结里也给了下一步建议:抽检访问量最高的自动分类页,持续按「一篇原文一次精读」补充,尤其是投资数据、医学指南和厂商效果数字这类需要一手来源的。
- 图片。 笔记同步助手自带图片本地化:把插件的「图片处理模式」切到「下载到本地」,图片会随文章一起下载到本地存储(默认
raw/images/,路径可改),不再受网络图片有效期限制,后续 wiki 引用图片、让模型看图都更方便。 - schema 是活的。 AGENTS.md 不是一次写完的东西。Codex 第一版给出的模板和命名规则可以用,但你会在用的过程中发现想改的地方——直接改,Codex 下次会话会照新的来。第二轮它就遇到一个:综述该用什么
type?schema 里没有synthesis,它选择沿用已允许的concept而不是凭空扩展类型,并把这个取舍写进了 log。
参考:
- Andrej Karpathy, LLM Wiki(2026-04)
- kepano, obsidian-skills
- 路径、笔记属性模板、图片模式的完整说明见教程中心的路径配置教程、笔记属性模板、图片处理模式